03 CUDA programming 2
Case Study 1
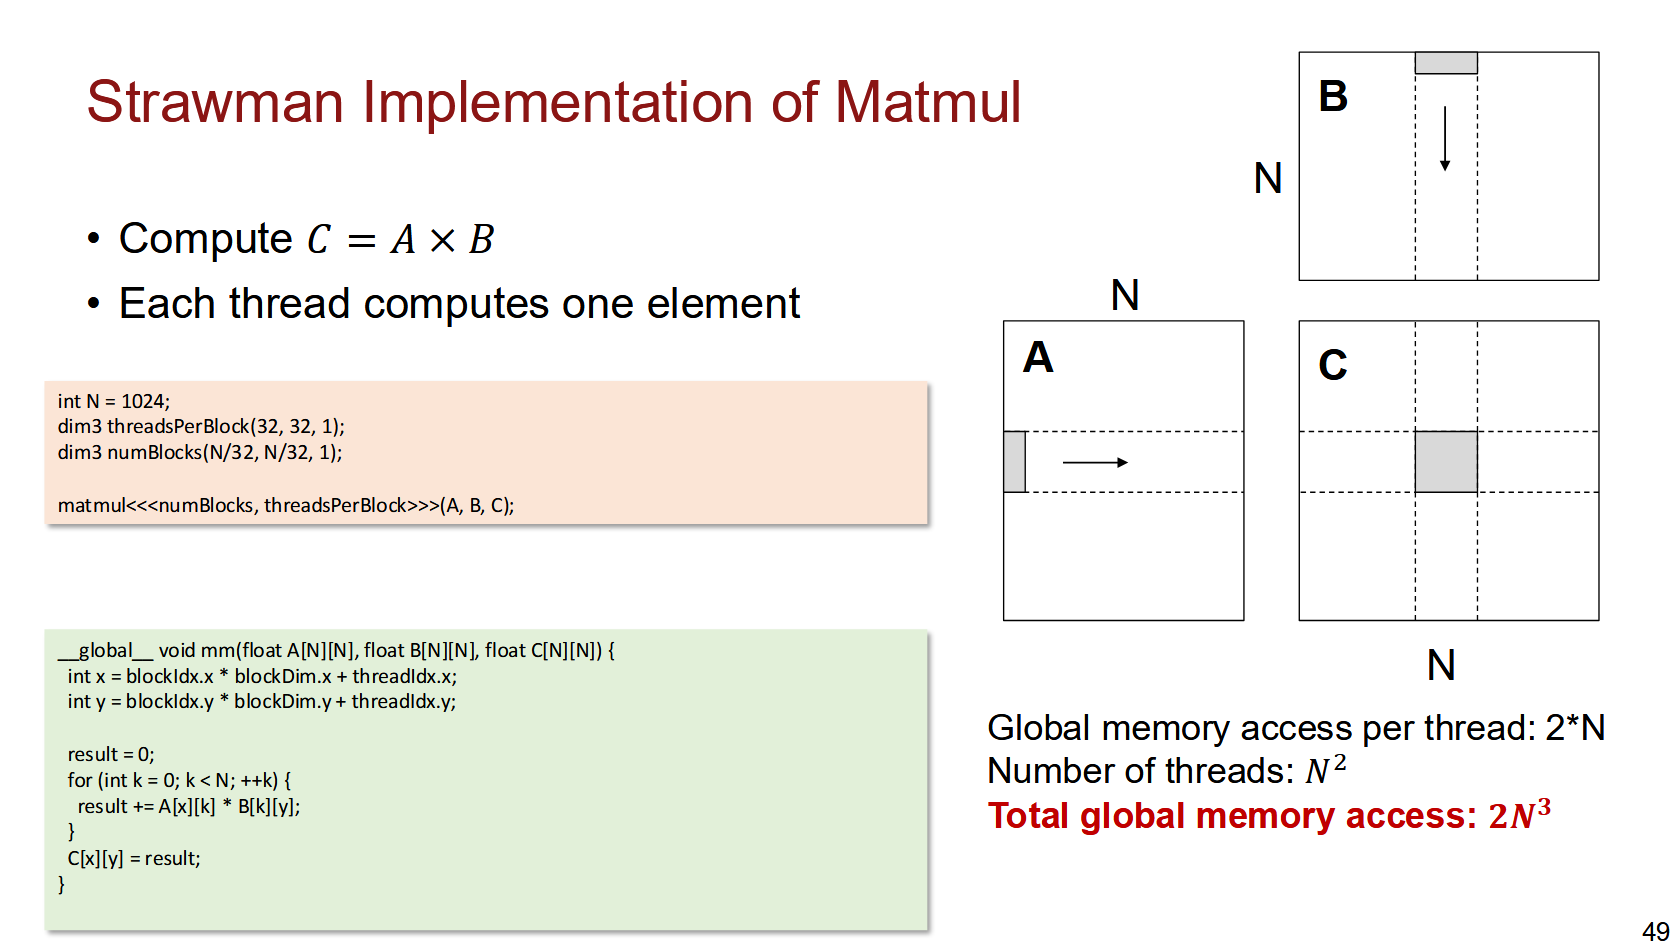
上面展示了一个最朴素的矩阵乘法,每个 thread 都会访问 A[x][k] 和 B[k][y],即每个 thread 会访问 Global Memory C[x][y] 一个元素的值,因此有
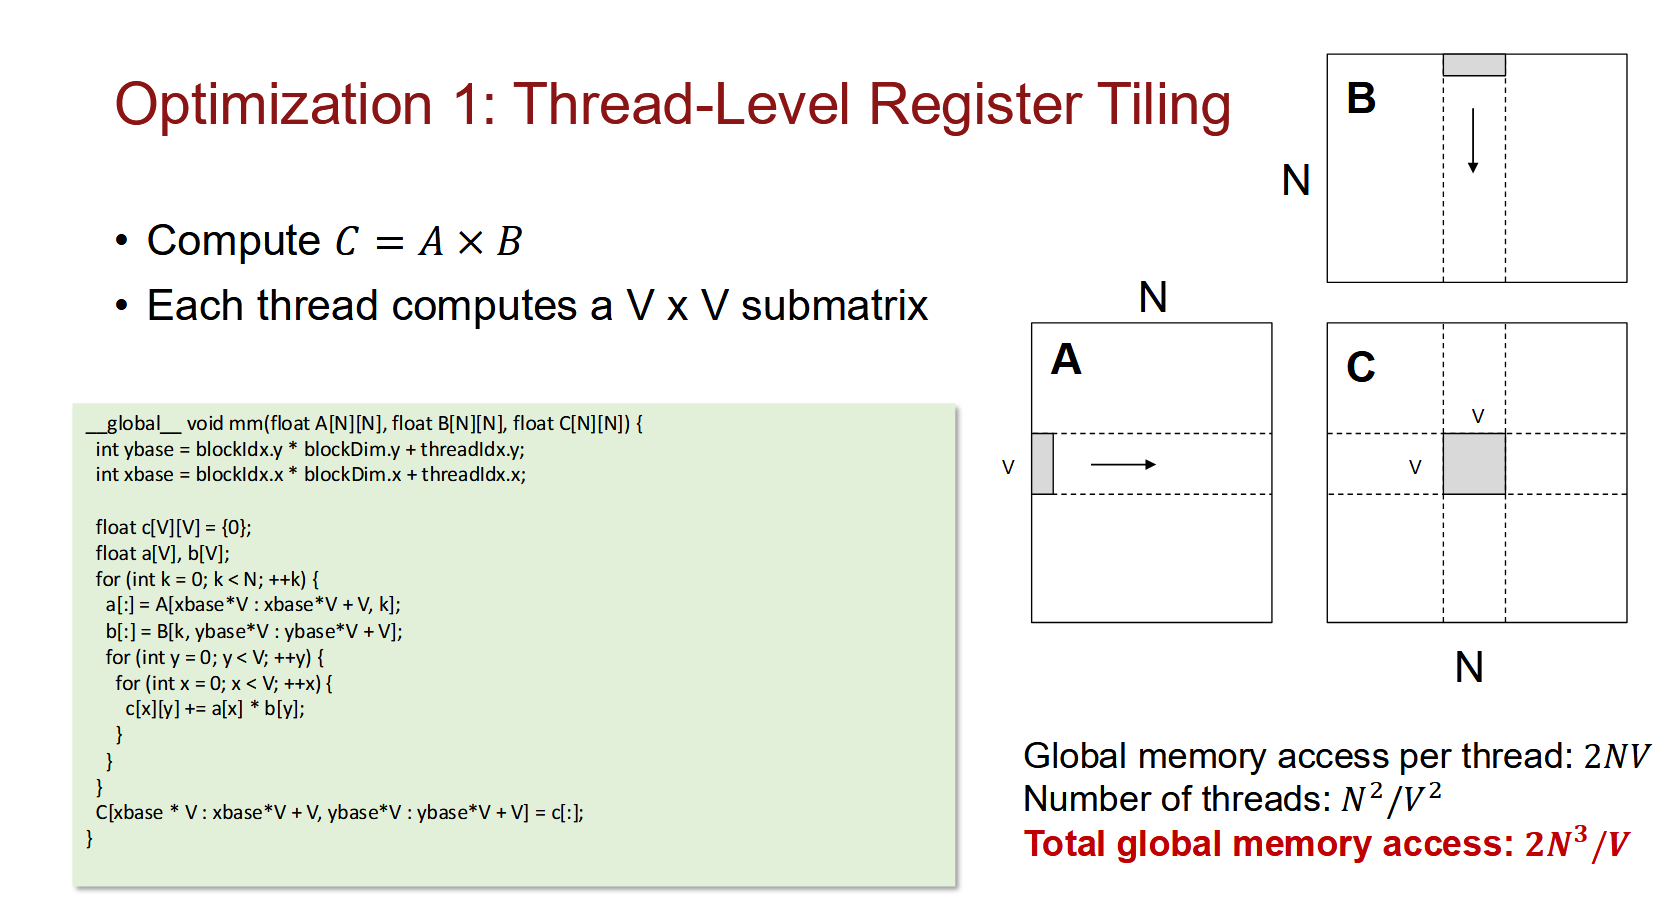
第一种优化:每个 thread 不再单独计算一个元素,而是计算 C[x][y] 到 C[x + V][y + V] 这块区域内的 A 和 B 的一部分数据先加载到 register 中(用 C 子矩阵边长,对应程序中的 a 和 b,即 a[:] = A[x: x + V][k])。通过这种优化,每个 thread 访问 Global Memory 的次数从
但如果
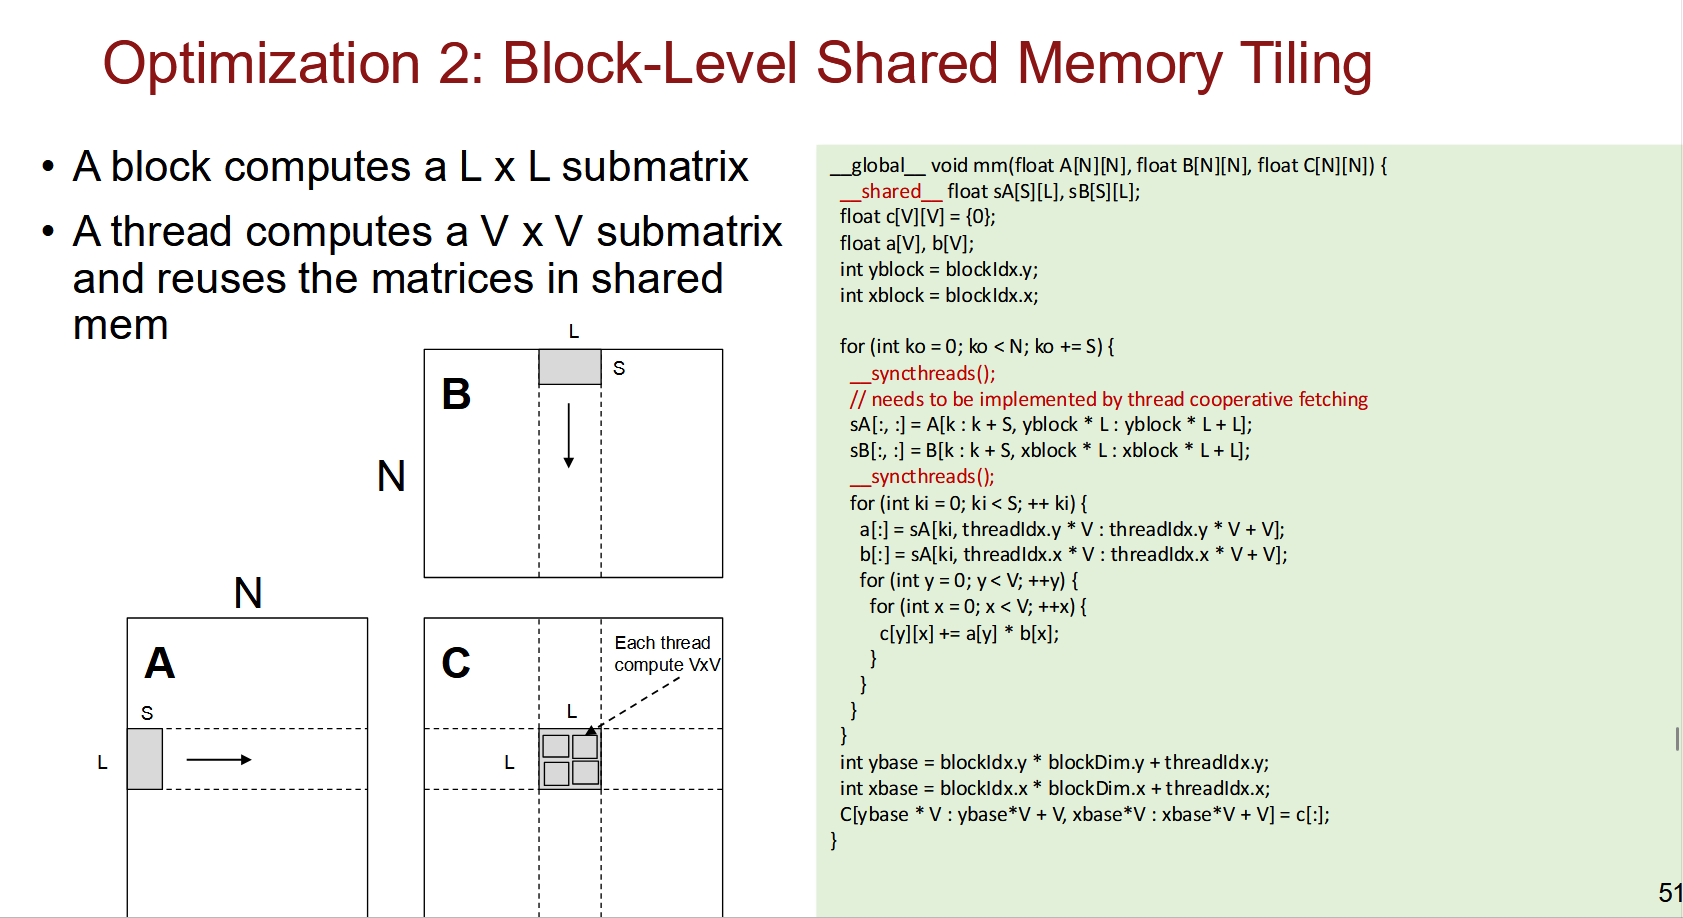
第二种优化:这种优化还会考虑 Block 内的 Shared Memory。在第一种优化的基础上,增加一个维度 k 这个维度上的分块大小,用 C 子矩阵边长,每次共享内存 sA 会加载 A[x: x + L][k: k + S] 这块区域的数据,然后寄存器上的 a 从 sA 中加载 A[x: x + V][k]。
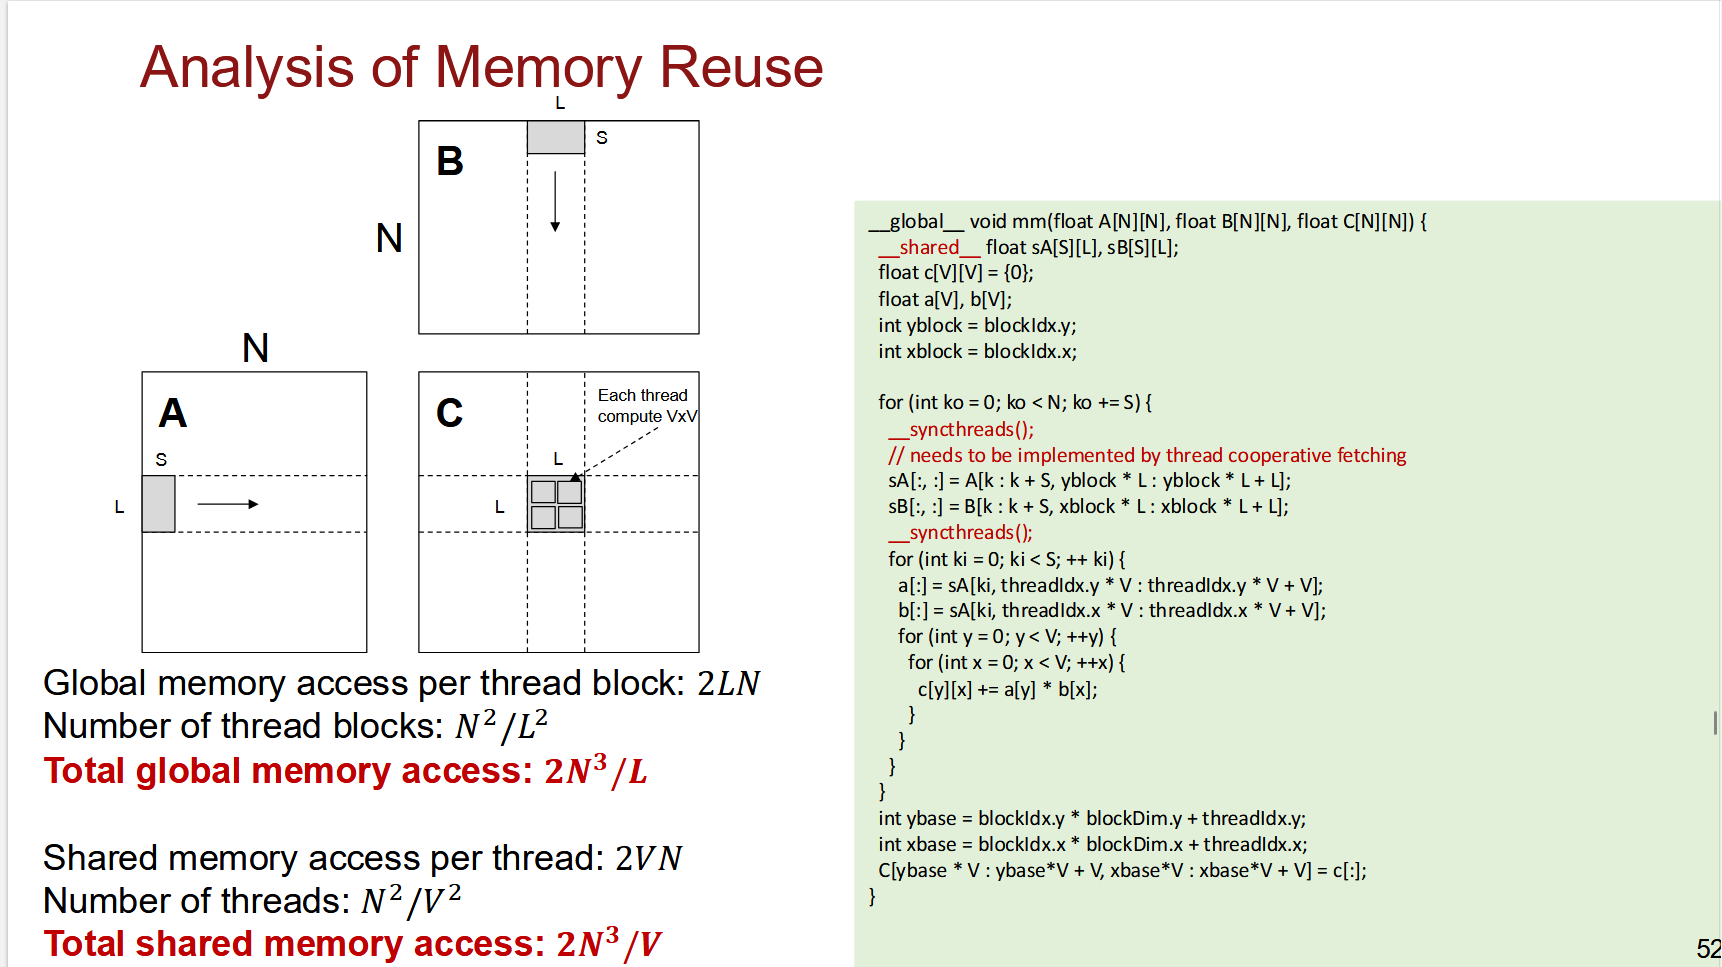
对 Memory Access 进行分析:Block 每次需要计算 A 和 B 中加载
实际上这里不仅需要考虑 Memory Access 的次数,因为使用了 __syncthreads 这个原语避免不同 Threads 在不同轮次的计算中的竞争,所以还需要考虑同步频率,这一步是由参数
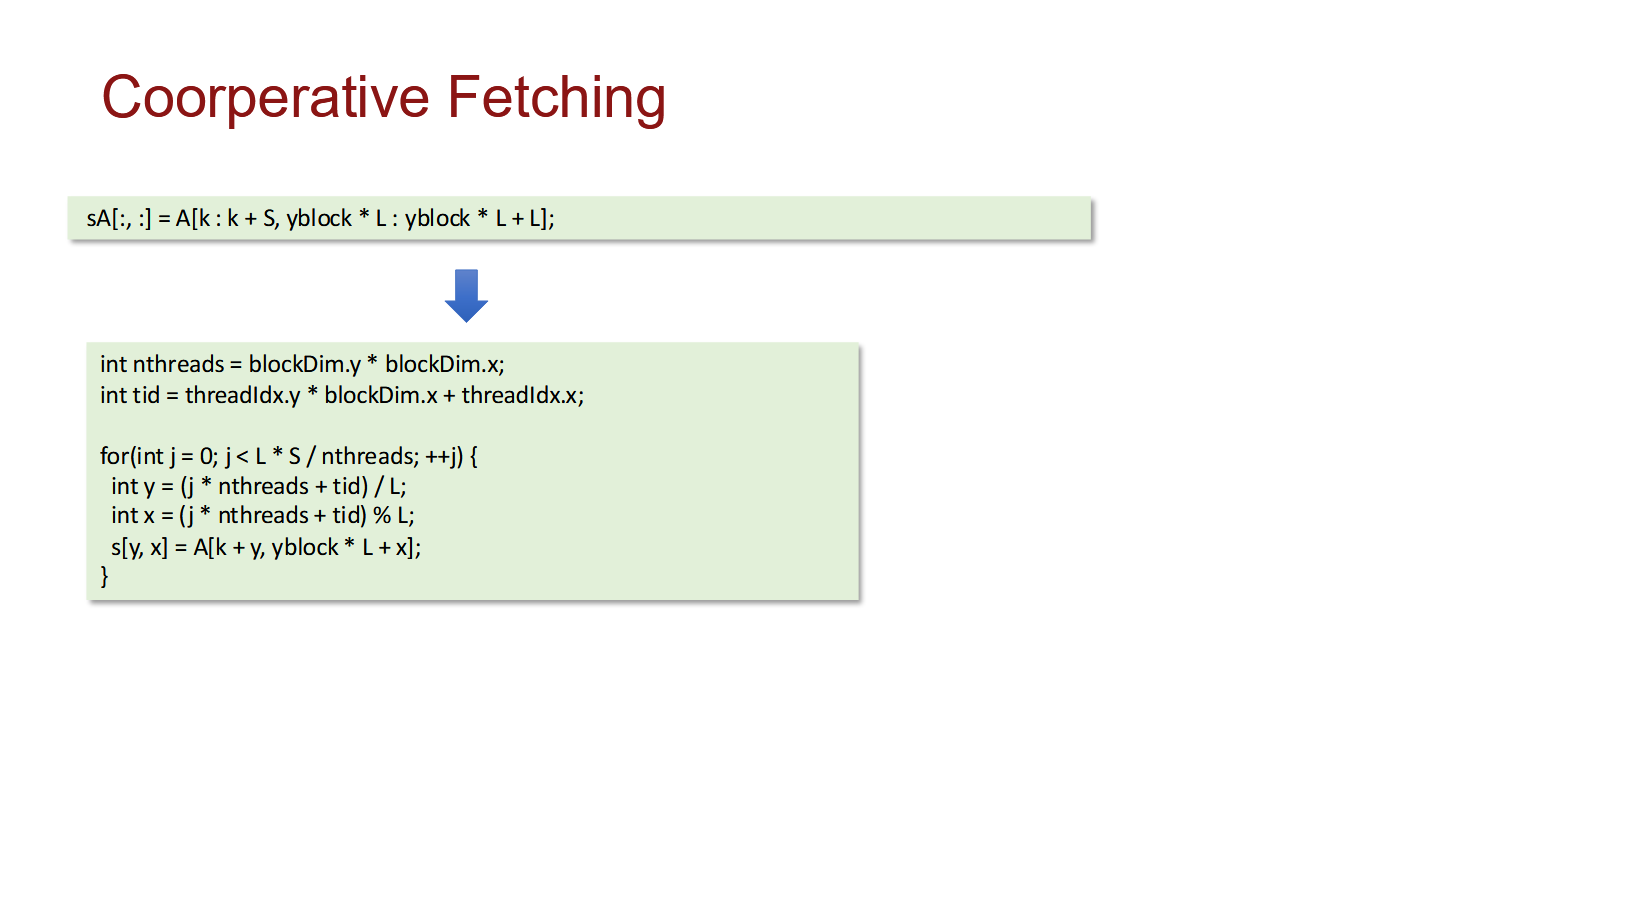
如何把上面的伪代码里的“整块数据搬运”操作,翻译成真正可执行的 CUDA C 代码,并让 Block 内所有线程一起干活?这段代码的核心逻辑是把二维 tile 拉平成一维,然后通过映射让所有线程按顺序做分工。
Case Study 2
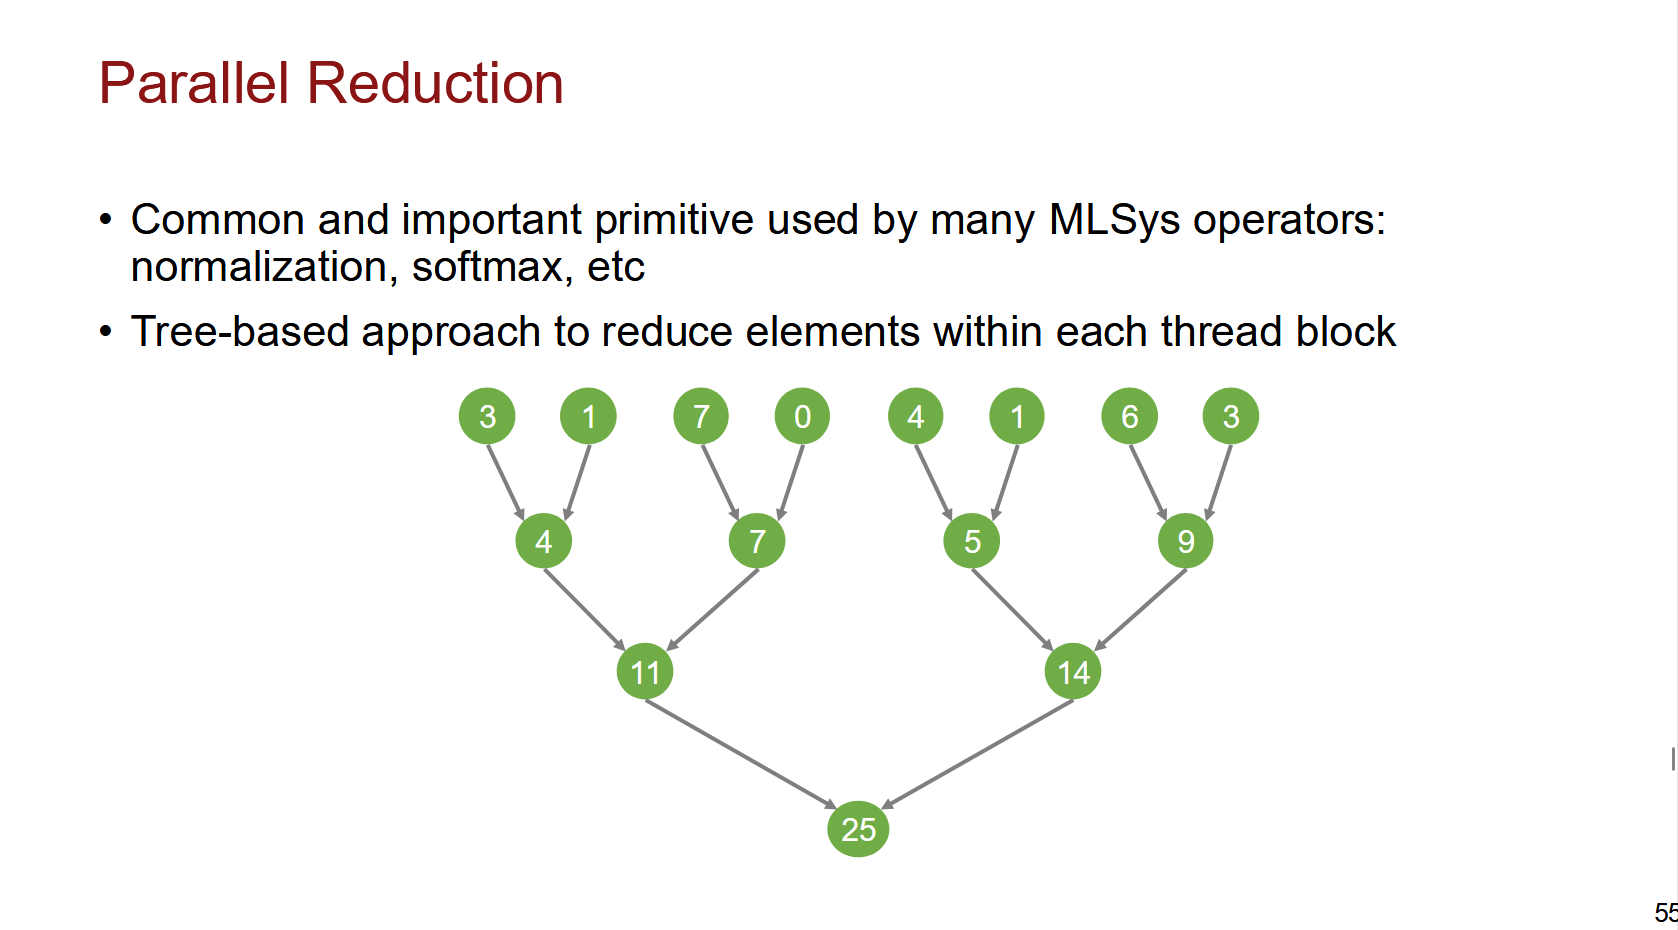
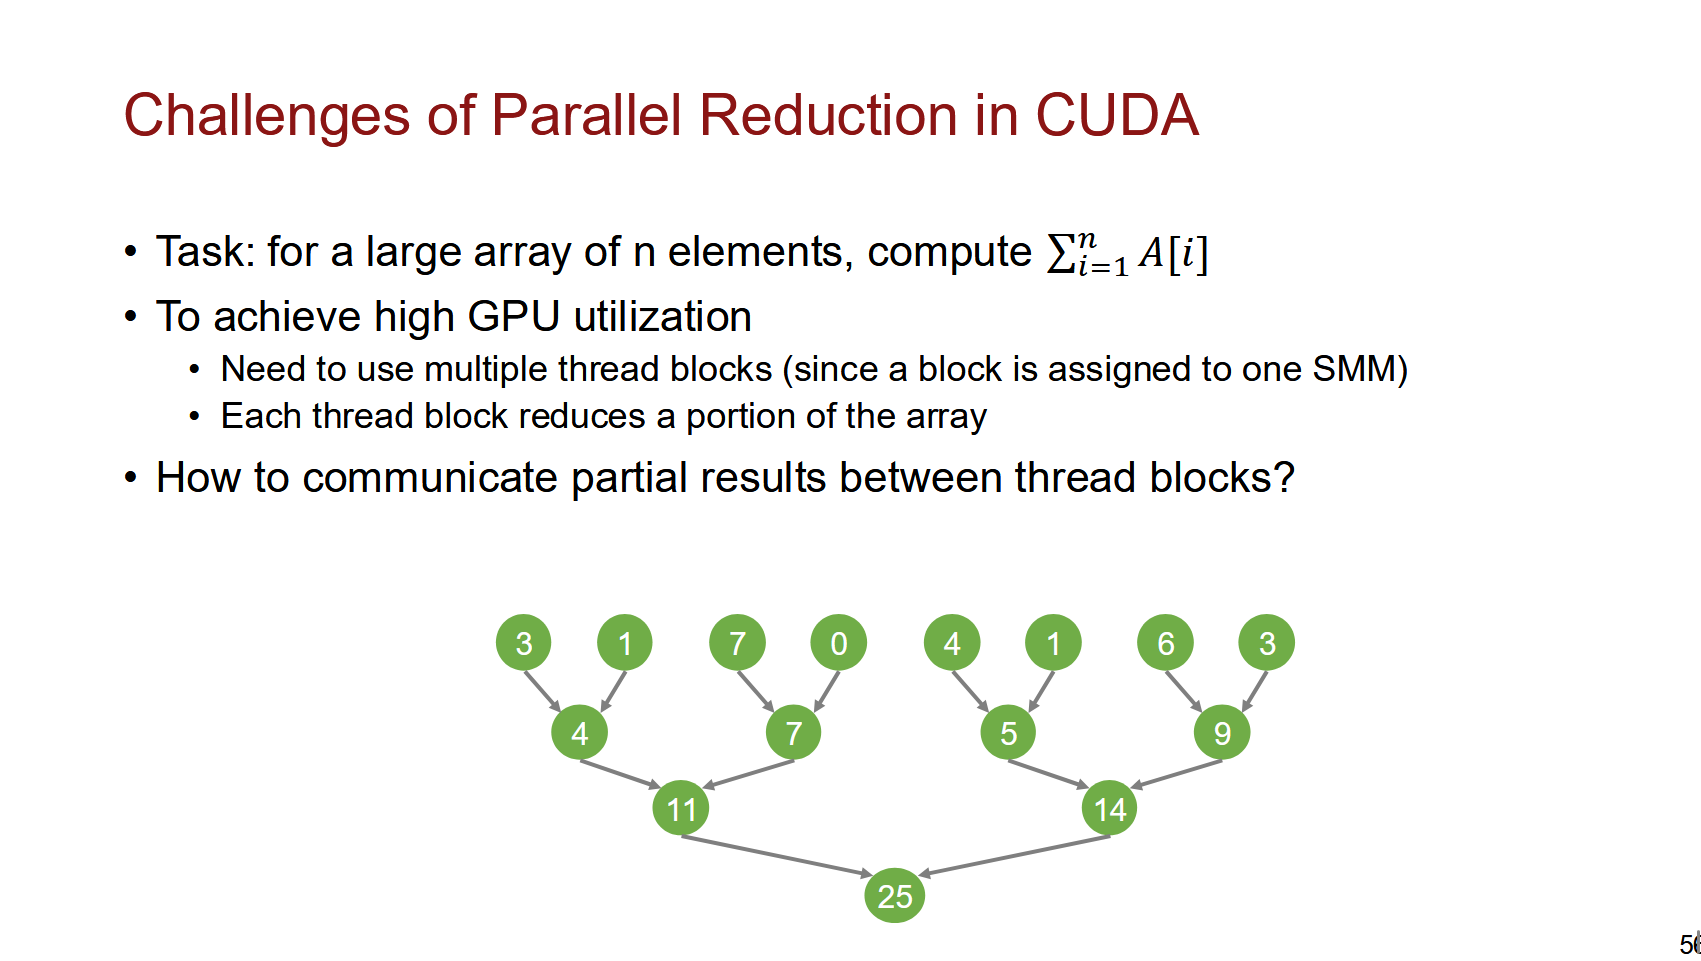
并行规约(Parallel Reduction)指将大量数据用算子进行合并的过程,类似函数式编程中的 reduce。在 CUDA 中可以使用近似树的结构来并行规约过程,使得复杂度从
这里我们用求和作为例子。
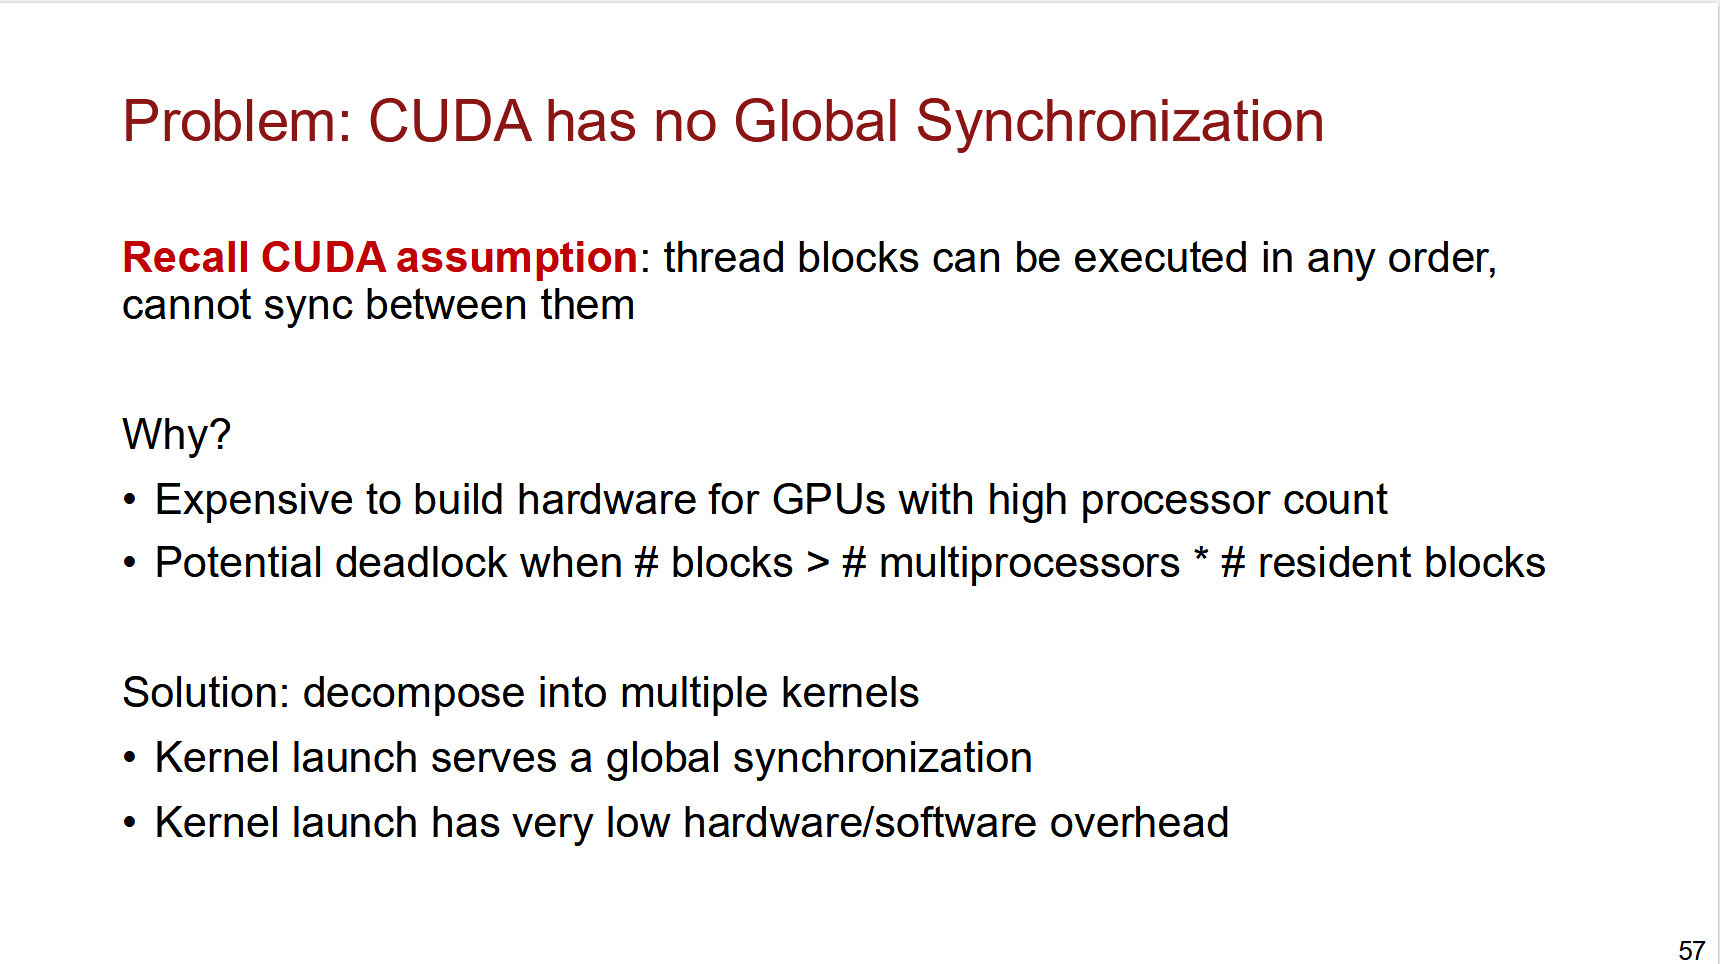
之前提过,CUDA 的一个前提是:Block 之间的运行可以以任意顺序进行。这代表 Block 之间并不像 Thread 那样有同步机制。这一方面受限于硬件设计,另一方面是为了规避潜在的死锁问题。一种解决方案是把整体的任务分解成多个 Kernel 启动。一次 Kernel 调用返回时,硬件会隐式保证该 Grid 的所有线程块都已执行完毕。因此,连续两次内核启动之间天然形成了一个全局同步点。
在 Parallel Reduction 的语境下,这意味着:
- 第一轮:启动大量 Block,各自归约局部数据,把中间结果写入 Global Memory。
- 第二轮:读取这些中间结果,继续归约,如此往复直到只剩一个标量。
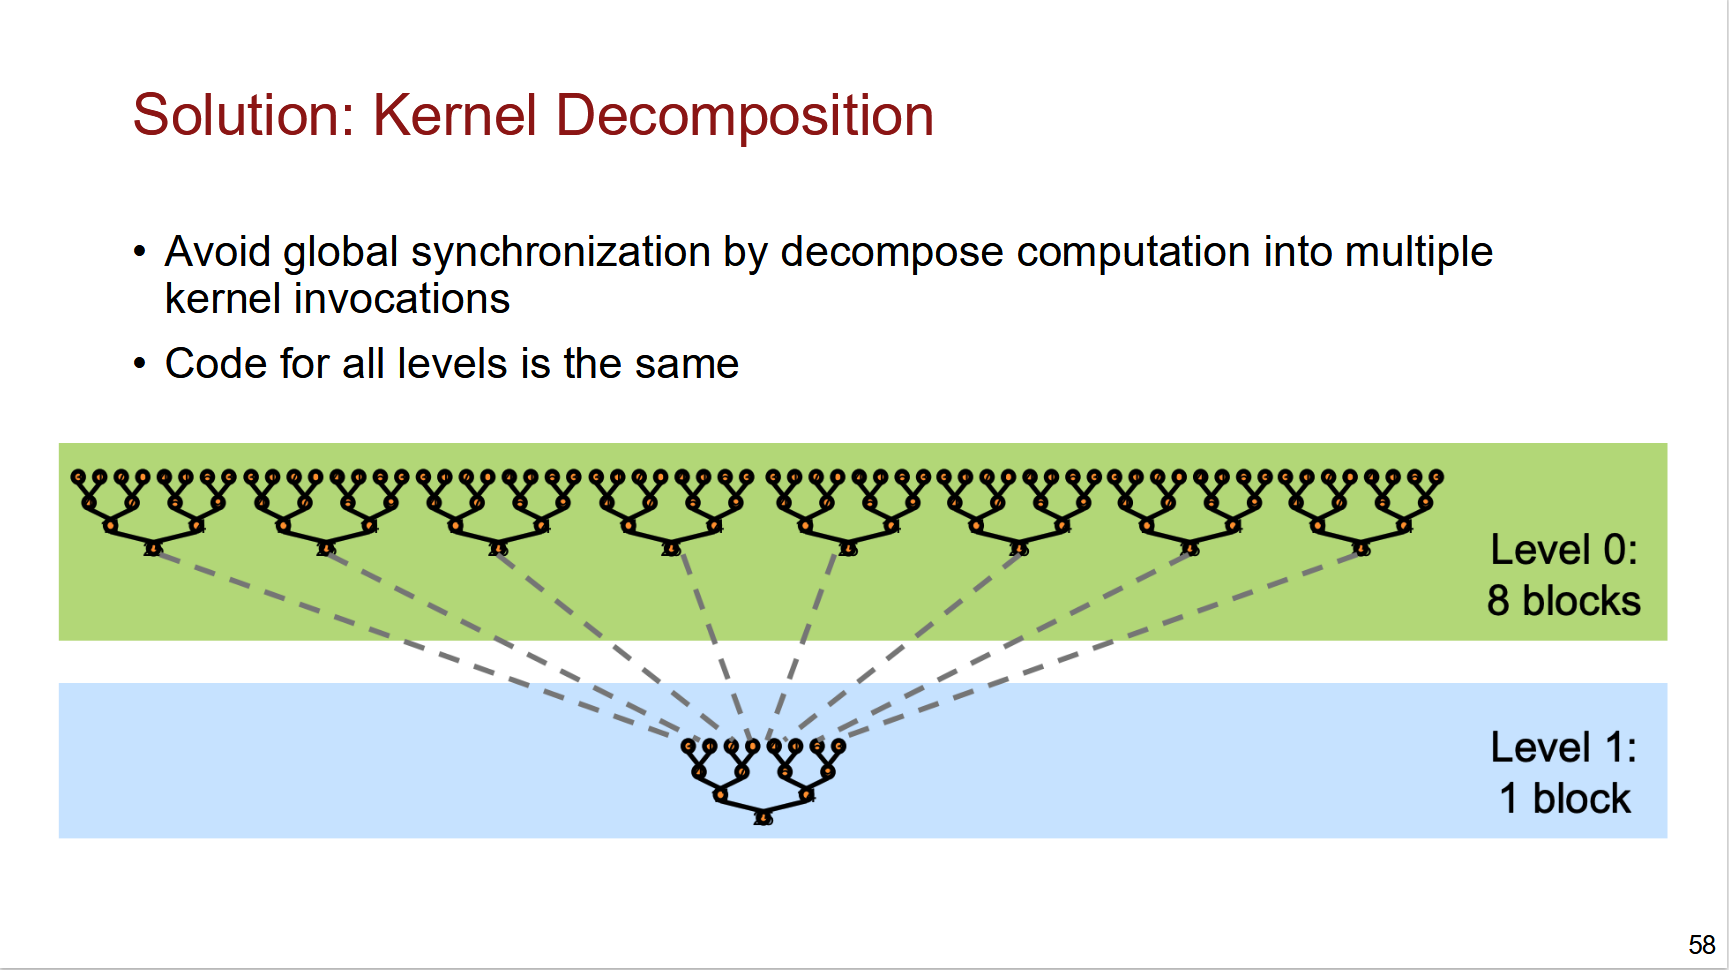
图中的蓝色区域和绿色区域对应两次独立的 Kernel 启动。两次 Kernel 启动可以复用同一套代码。
下面讨论一次 Kernel 启动内的规约过程。
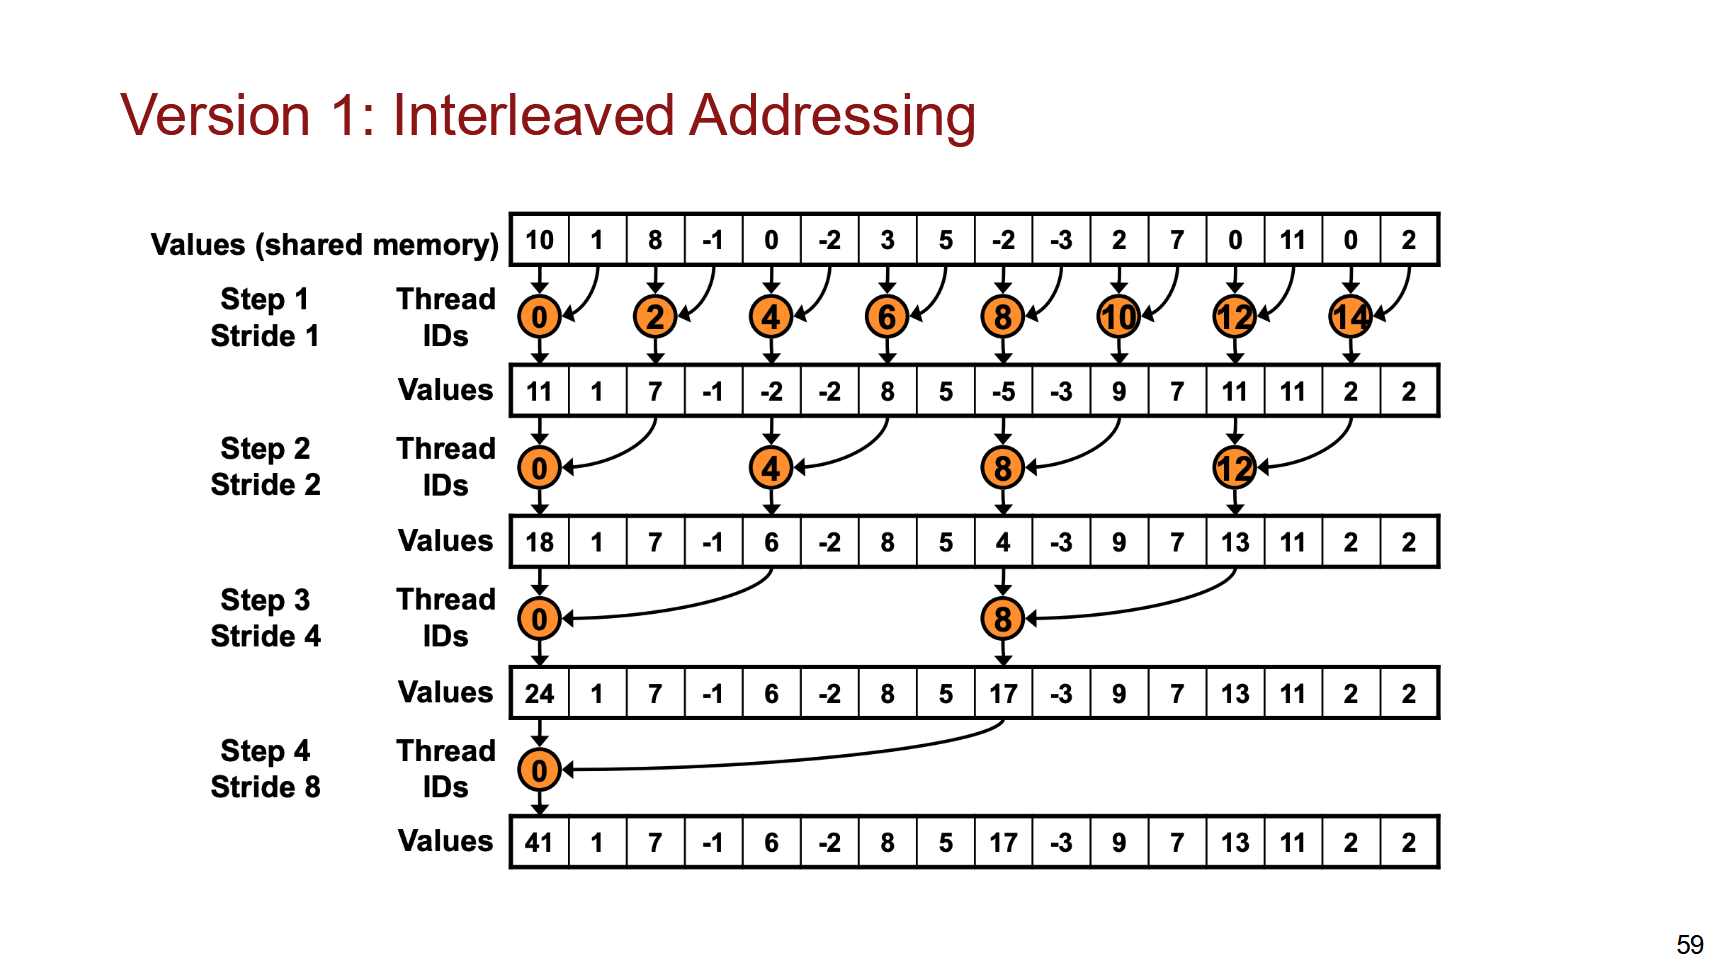
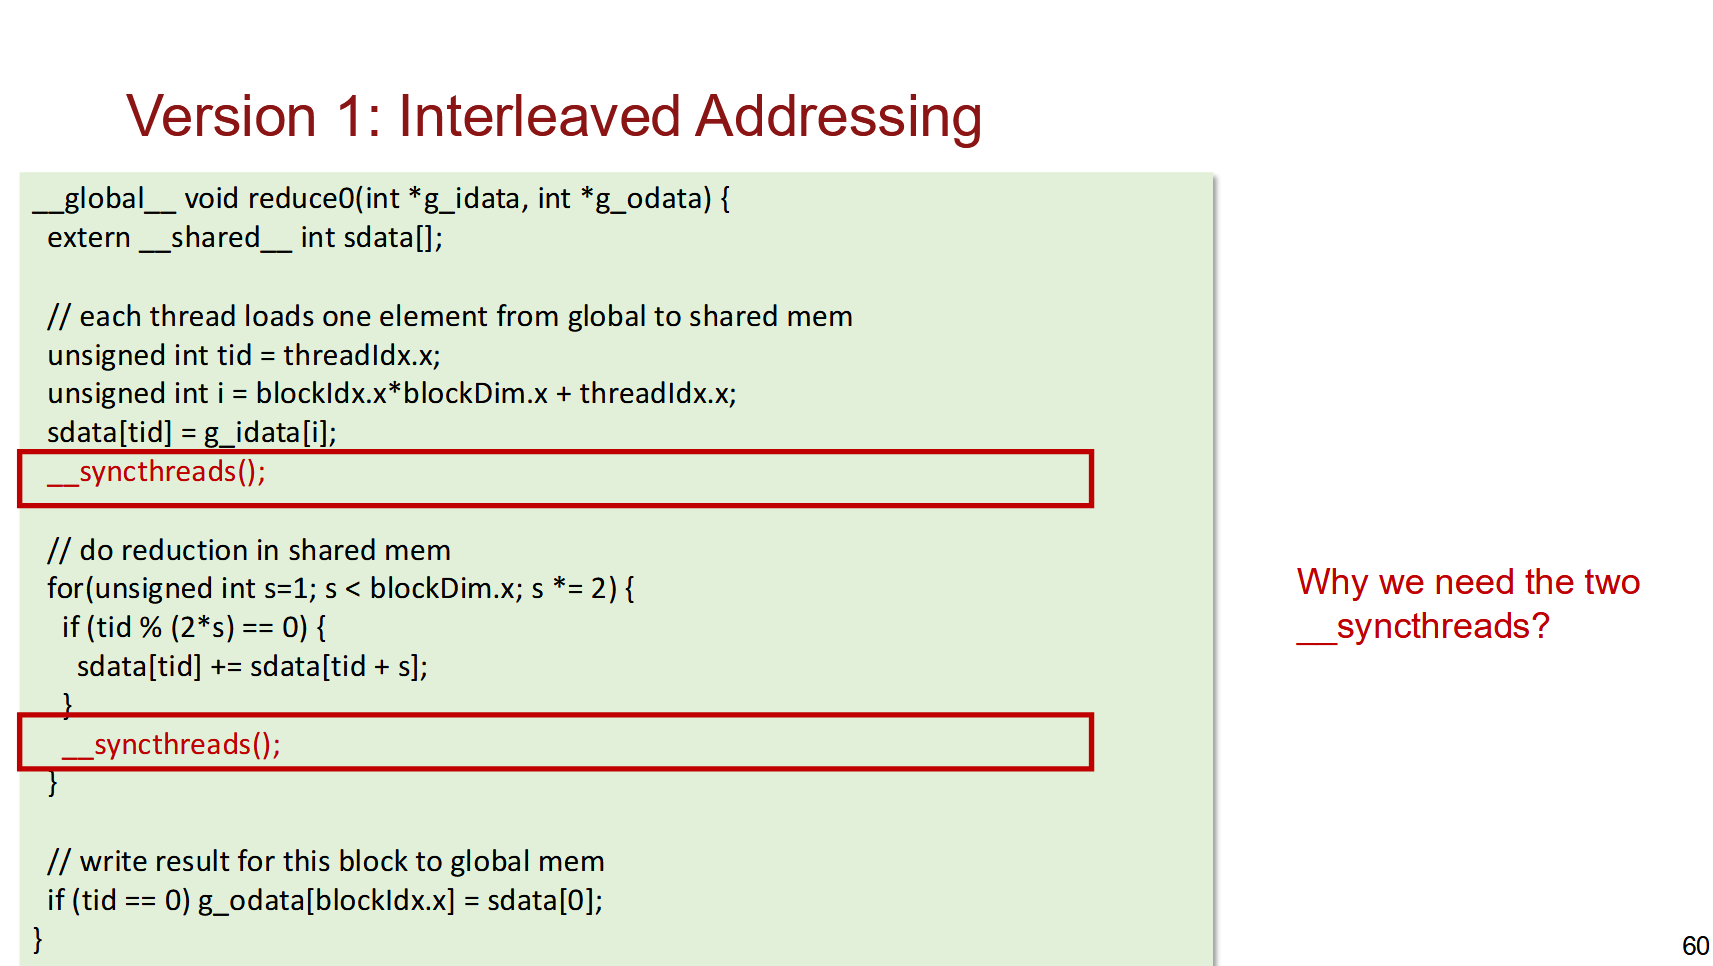
第一个实现:使用了最直观的树形规约的思路。这里需要两个 __syncthreads,第一个用于保证所有线程都已经从 Global Memory 中加载了正确的数据到 Shared Memory 中,避免读到脏数据;第二个用于保证每个位置都已经被正确更新,避免下一轮迭代时读到脏数据。
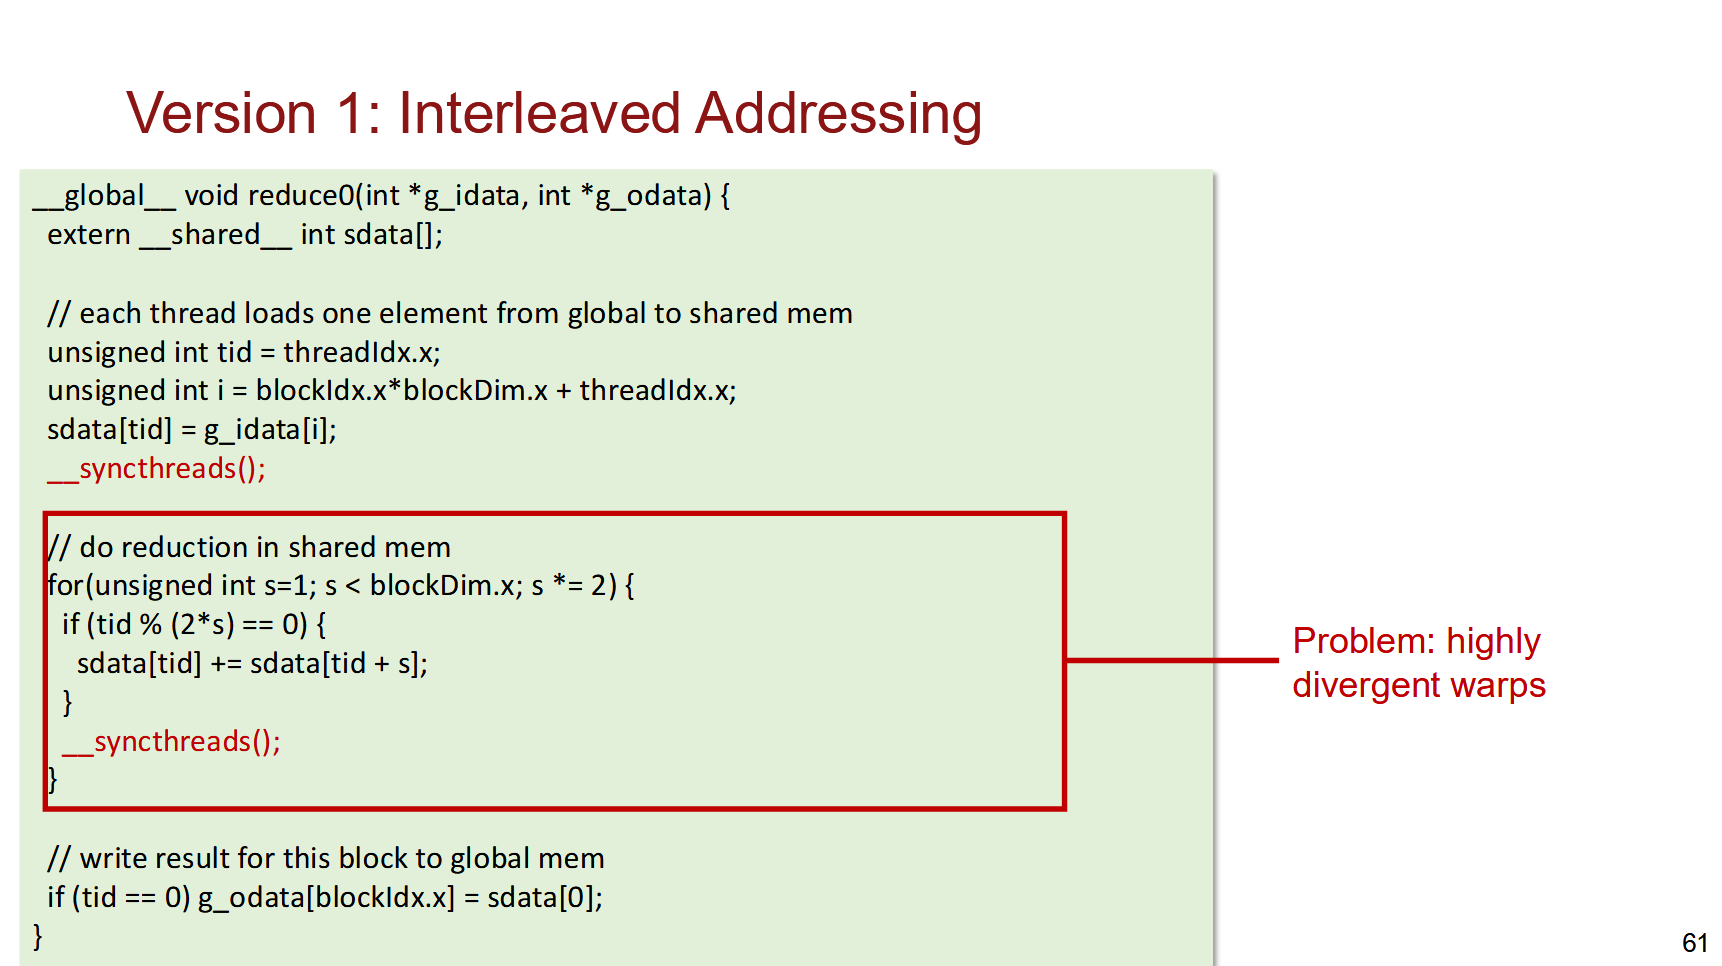
但是这个实现版本具有严重的 divergence 问题,在不同的执行分支,同一个 wrap 内的某些线程可能会被阻塞。
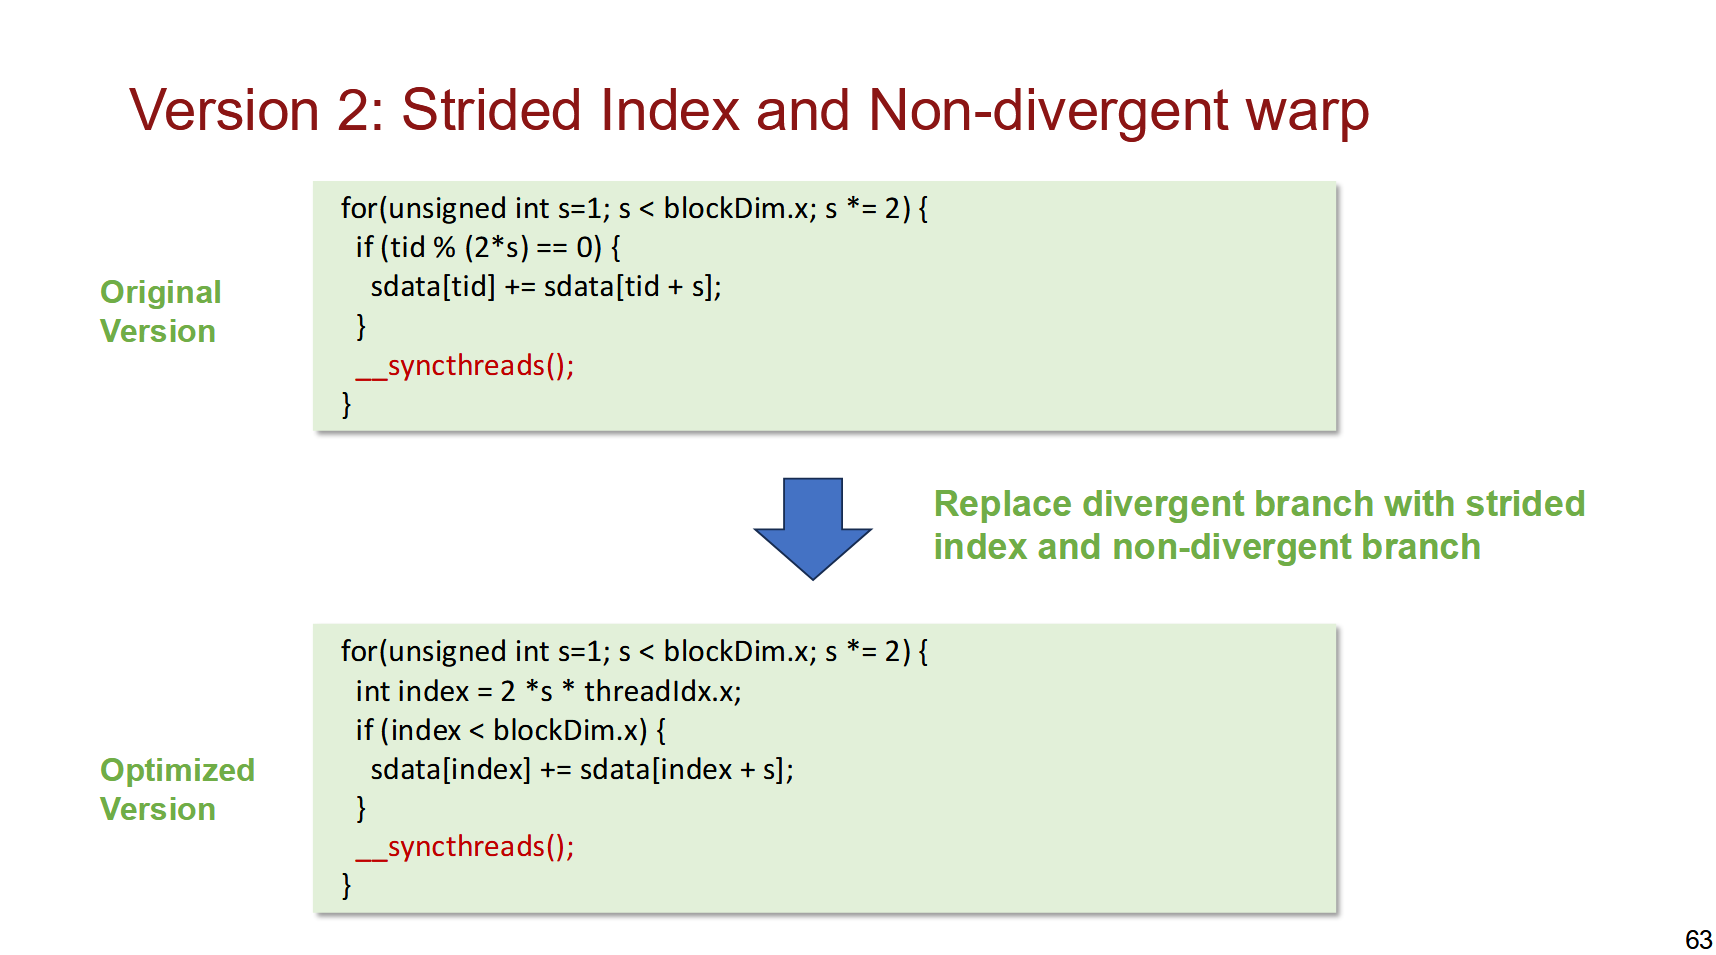
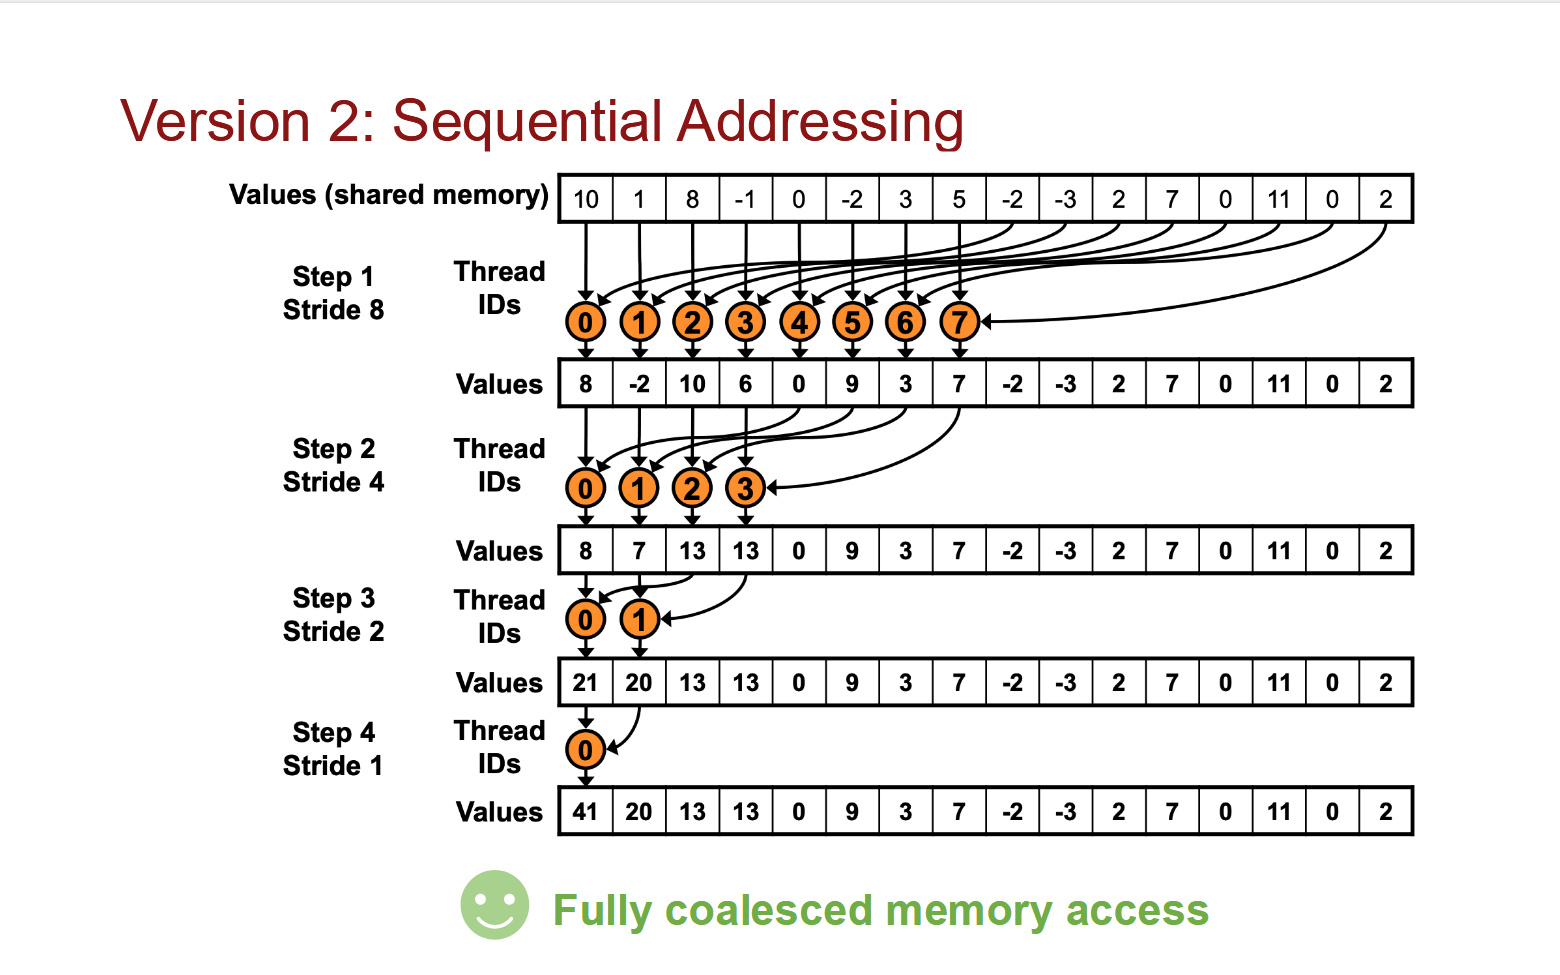
第二个实现:关键优化是不再让线程按 tid 直接索引数据位置,而是让线程 tid 负责处理 index = 2*s*tid 处的数据,最后的效果如下图所示。这么做可以保证线程是连续工作/连续阻塞的,避免了同一个 wrap 内的线程出现 divergence 的问题。
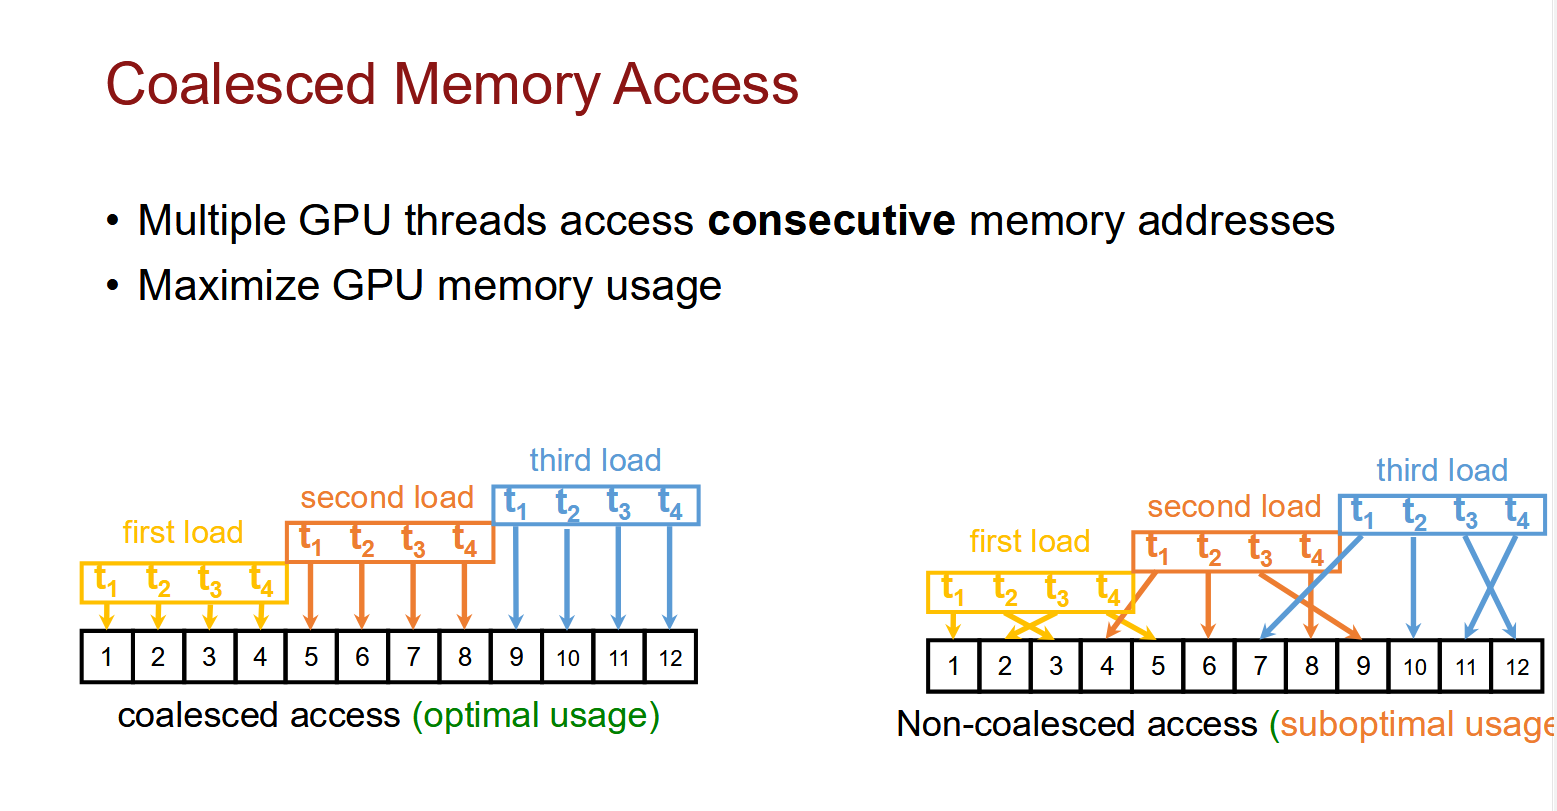
当一个 Warp 内的线程同时访问内存时,如果它们的地址是连续的(例如线程 i 访问地址 base + i),GPU 内存控制器就能将这些请求合并为最少次数的内存事务完成传输。反之,如果地址分散或跳跃,就会产生大量额外的事务,严重浪费带宽。之前的优化虽然消除了 divergence,但其 index = 2*s*tid 的步长索引方式在内存布局上仍然可能导致非合并访问。