08 Tile-based DSL
- Triton 相比于 PyTorch 位于更低的抽象层次。
- 支持所有的 Python 控制结构。
- Python 代码会被具体到 Triton IR。
Triton 可以看作是基于 Python 构建的 DSL。在 PyTorch 中,我们实际上是面向网络结构进行编程,比如:
# PyTorch
z = x + y
定义了一个网络结构,张量 z 的值是张量 x 和张量 y 的和。
在 Triton 中,我们是面向一个数据块进行编程:
# Triton
@triton.jit
def add_kernel(x_ptr, y_ptr, out_ptr, n, BLOCK_SIZE: tl.constexpr):
    pid = tl.program_id(axis=0)
    mask = offsets < n

    x = tl.load(x_ptr + offsets, mask=mask)
    y = tl.load(y_ptr + offsets, mask=mask)
    tl.store(out_ptr + offsets, x + y, mask=mask)
这意味着我们可以控制数据块大小、内存访问模式,甚至可以像之前的 Mega Kernel 融合多个操作。
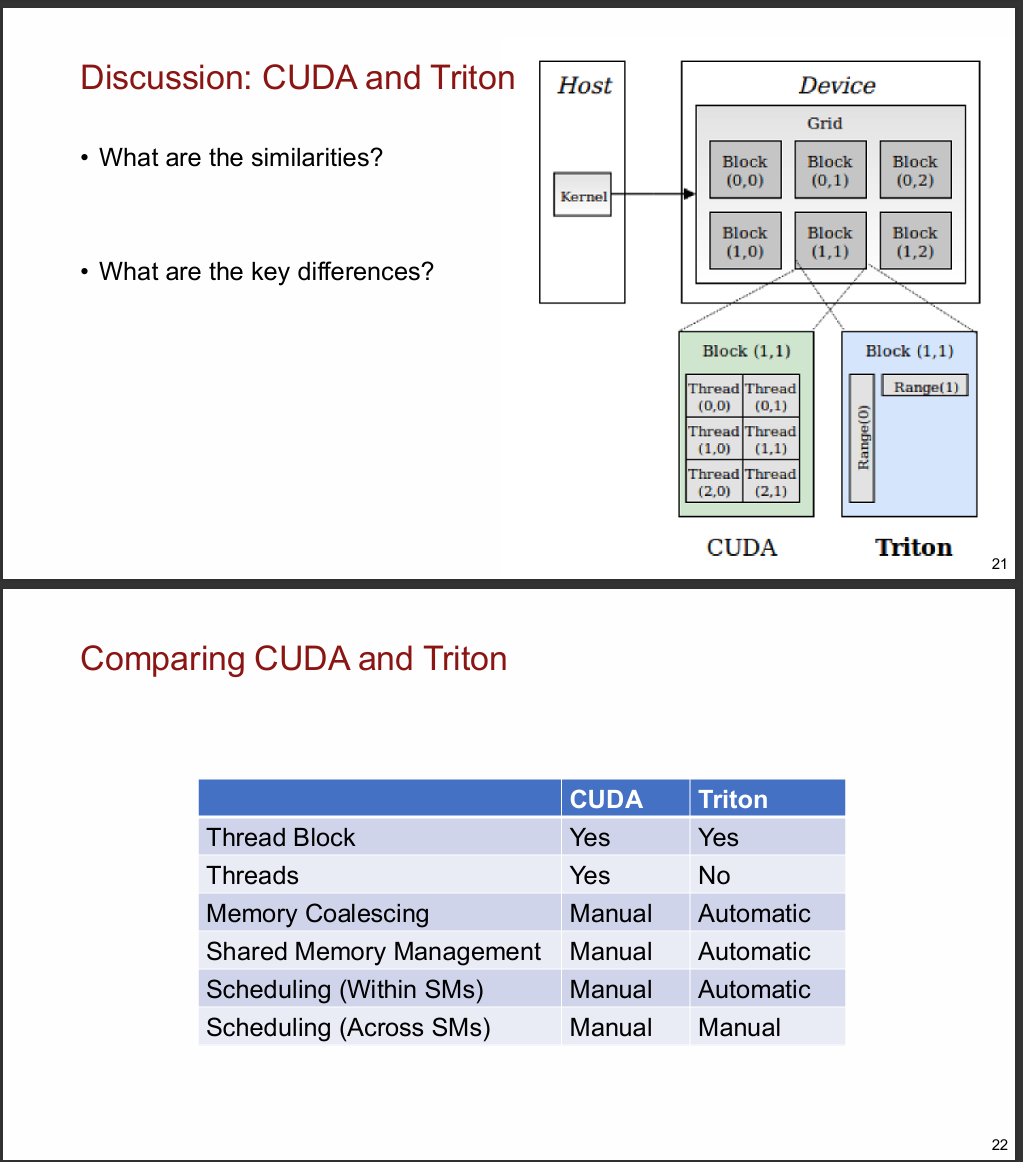
但是 Triton 比 CUDA 又位于更高的抽象层次。在 CUDA 中,我们是面向一个线程进行编程:
__global__ void add(float* x, float* y, float* out, int n) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < n) {
        out[i] = x[i] + y[i];
    }
}
起码在这个例子上,CUDA 使得我们需要花精力来计算线程索引和管理 Share Memory。
- 张量可以具有指针数据类型。
- 张量在 GPU 共享内存中。
- 输入可以是 PyTorch 张量,或者自定义数据结构,例如指针张量。
这是相对于 PyTorch 而言的。第一句话指 PyTorch 的张量你只能把它当作 Global Memory 里的一堆数据,而 Triton 的张量模型直接到了 GPU 的 Share Memory 这一层—第二句话说 Triton 内张量的元素类型可以是指针,这意味着可以控制一些不规则的内存数据结构。
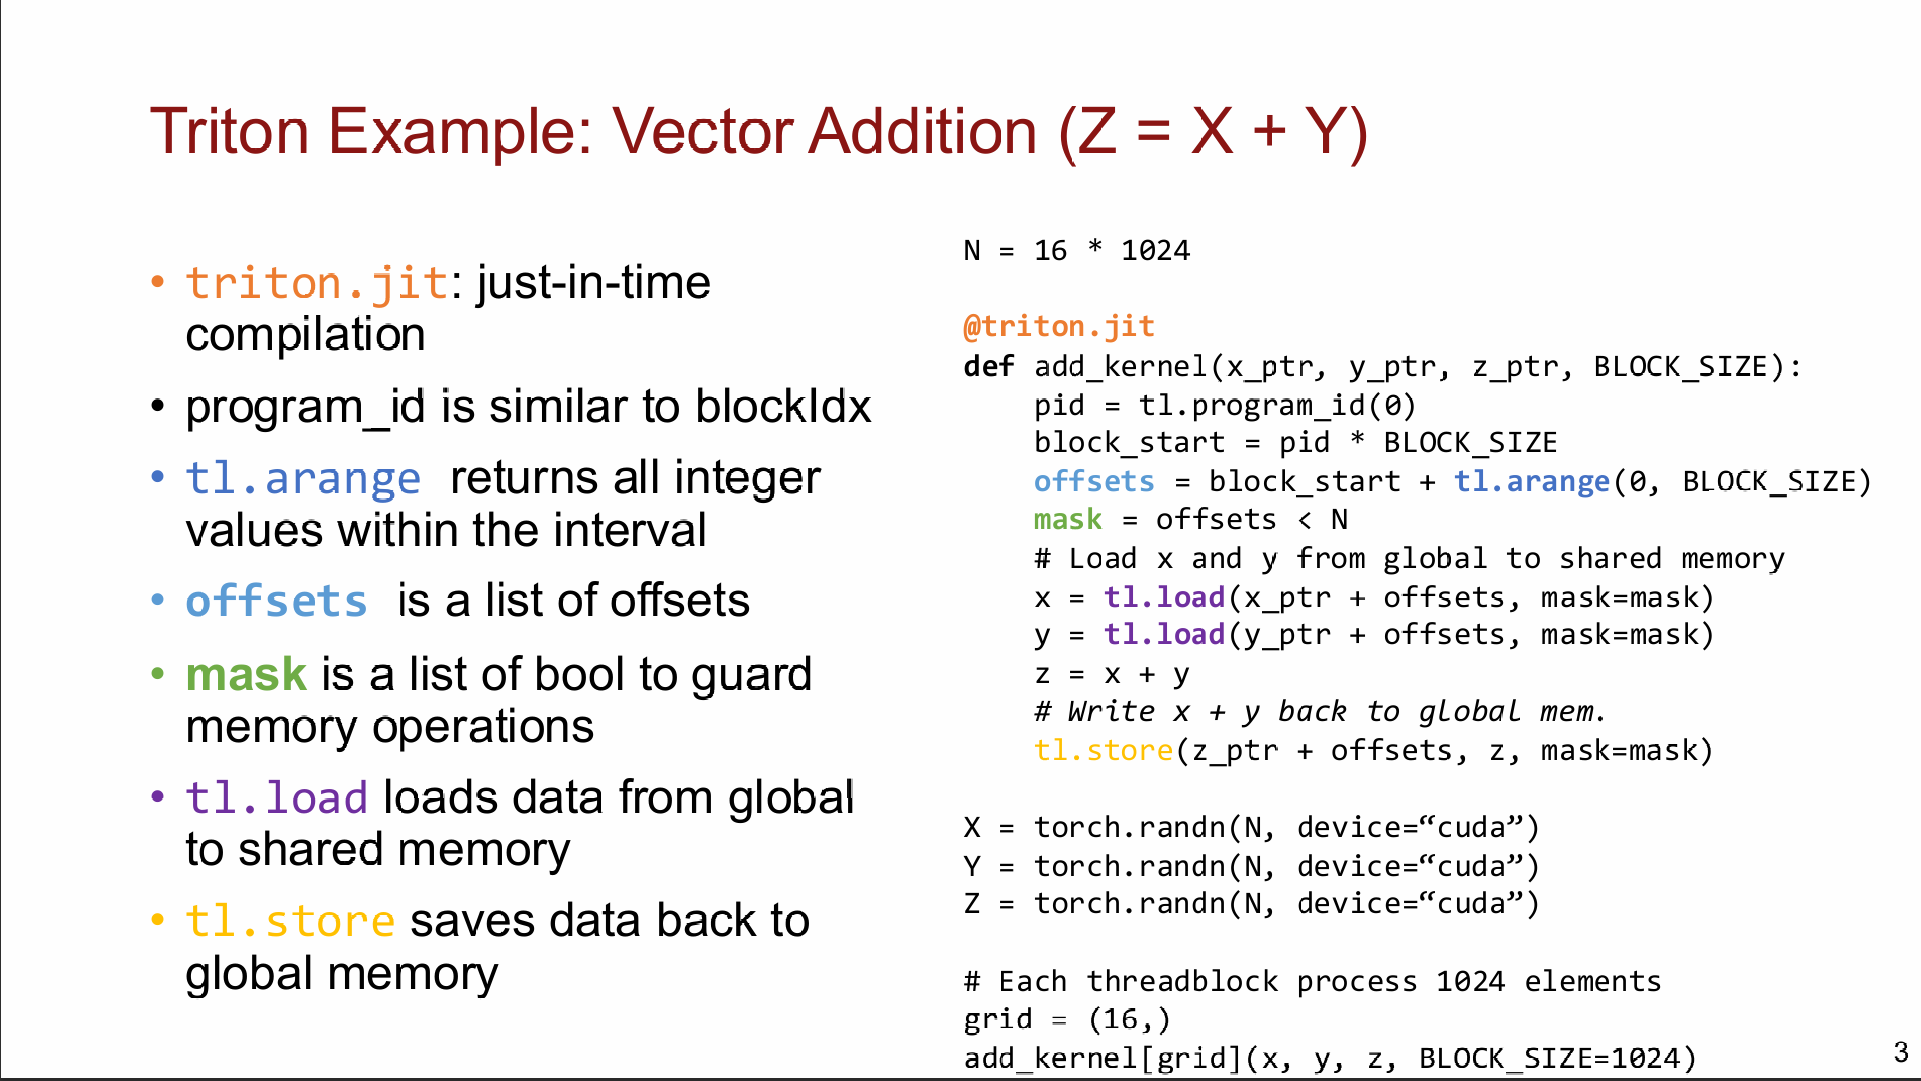
右侧是一个 Triton 代码示例,计算 Z = X + Y。左侧是部分代码解释:
@triton.jit指 Just-In-Time 编译,指这个 Kernel 会在第一次运行时被编译。program_id是一个内置函数,返回当前线程的 ID。CUDA 里每个 block 有编号 blockIdx,Triton 里把这个调度单位叫 program,tl.program_id(0)取的就是第几个程序块,0表示第一个维度,等同于 CUDA 的blockIdx.x。tl.arange生成[0, 1, 2, ..., 1023]这样一个向量,类似 NumPy 的np.arange。offsets通过block_start + tl.arange(...)得到本块负责的所有元素的全局下标。mask是一个与 offsets 等长的真值列表,逐元素决定“这个位置要不要真正读写”。作用是防止越界访问。tl.load把数据从全局内存加载到共享内存。tl.store把数据从共享内存写回全局内存。
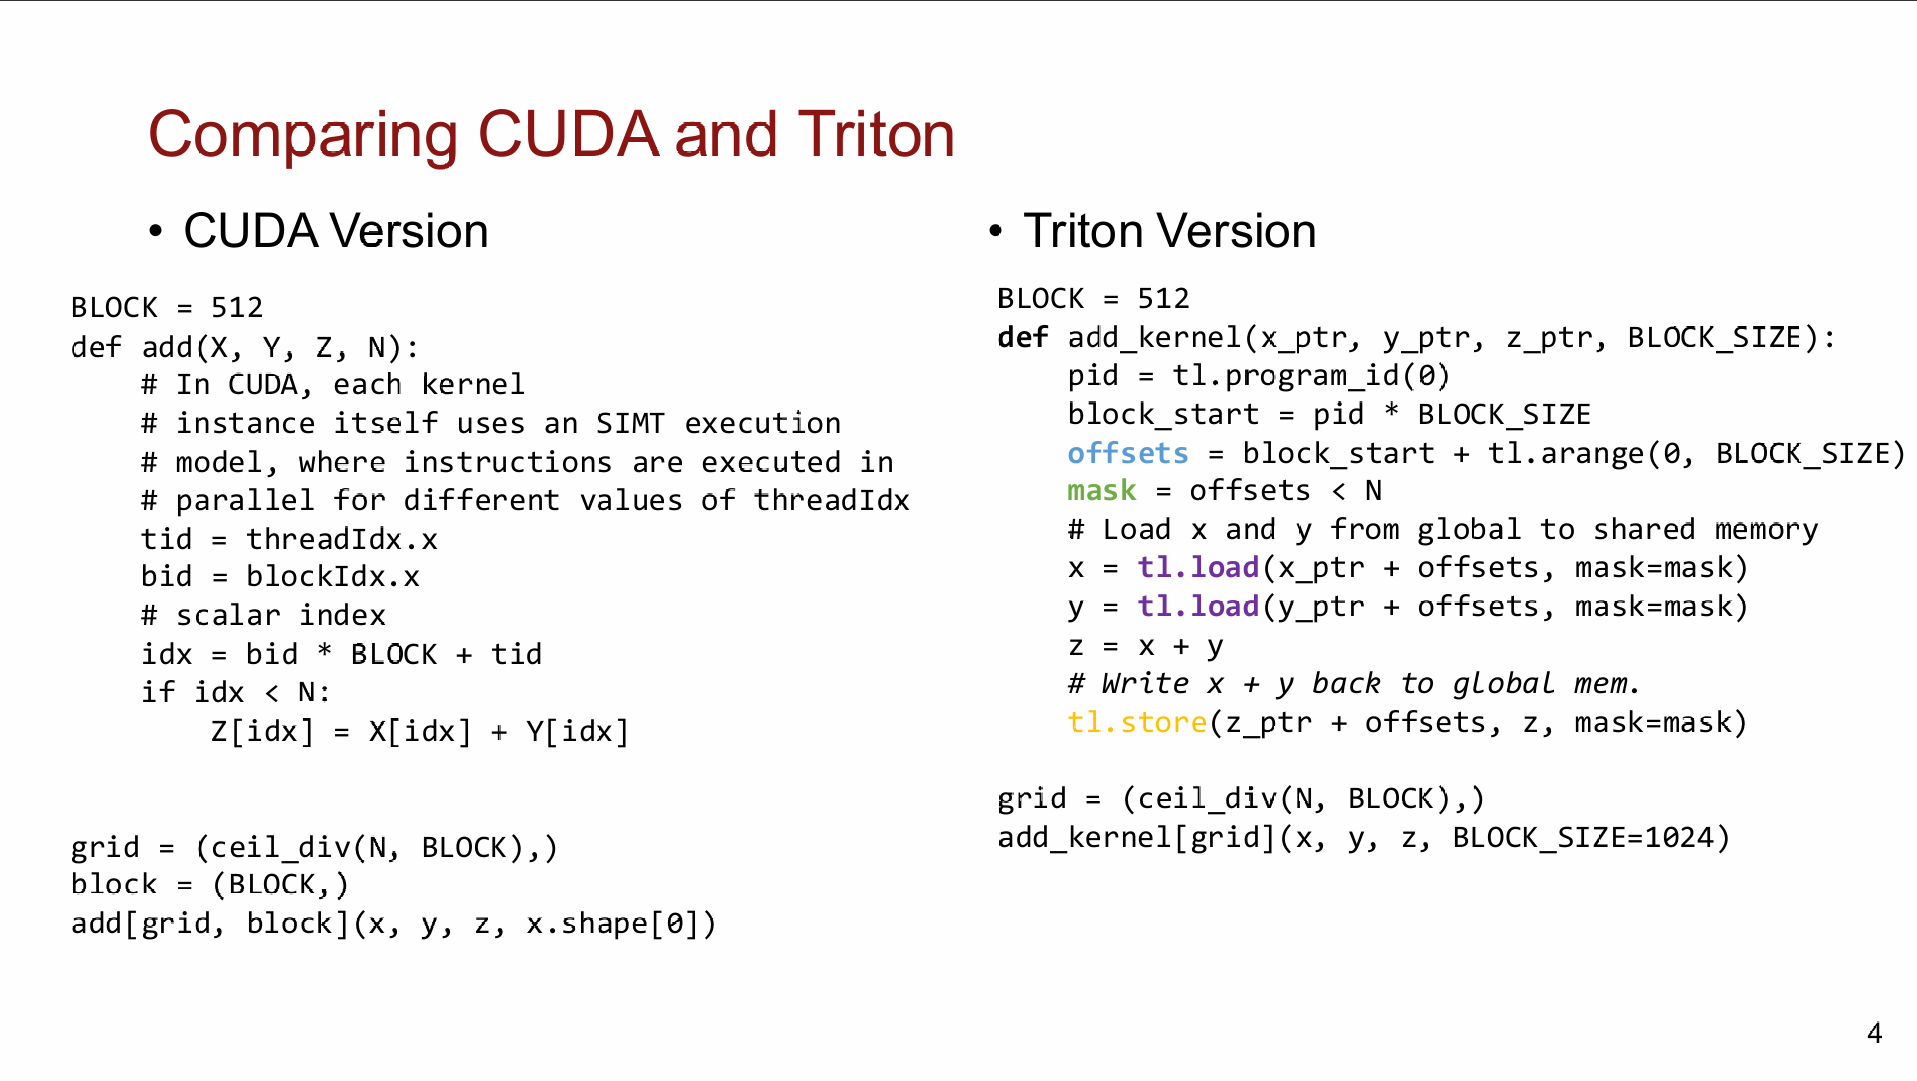
CUDA 采用 SIMT 模型,以单个线程的视角写代码:每个线程手工计算标量索引 idx = blockIdx.x * BLOCK + threadIdx.x,用 if idx < N 逐线程判断越界,启动时还须同时指定 grid 和每块线程数。控制粒度细、性能上限高,但并行调度等细节全部要自己管。
Triton 以程序块(tile)的视角写代码:program_id(0) 取块编号,tl.arange 一行生成向量索引 offsets,越界保护用 mask 传给 tl.load/tl.store,启动只需指定 grid,线程数等由编译器自动决定。
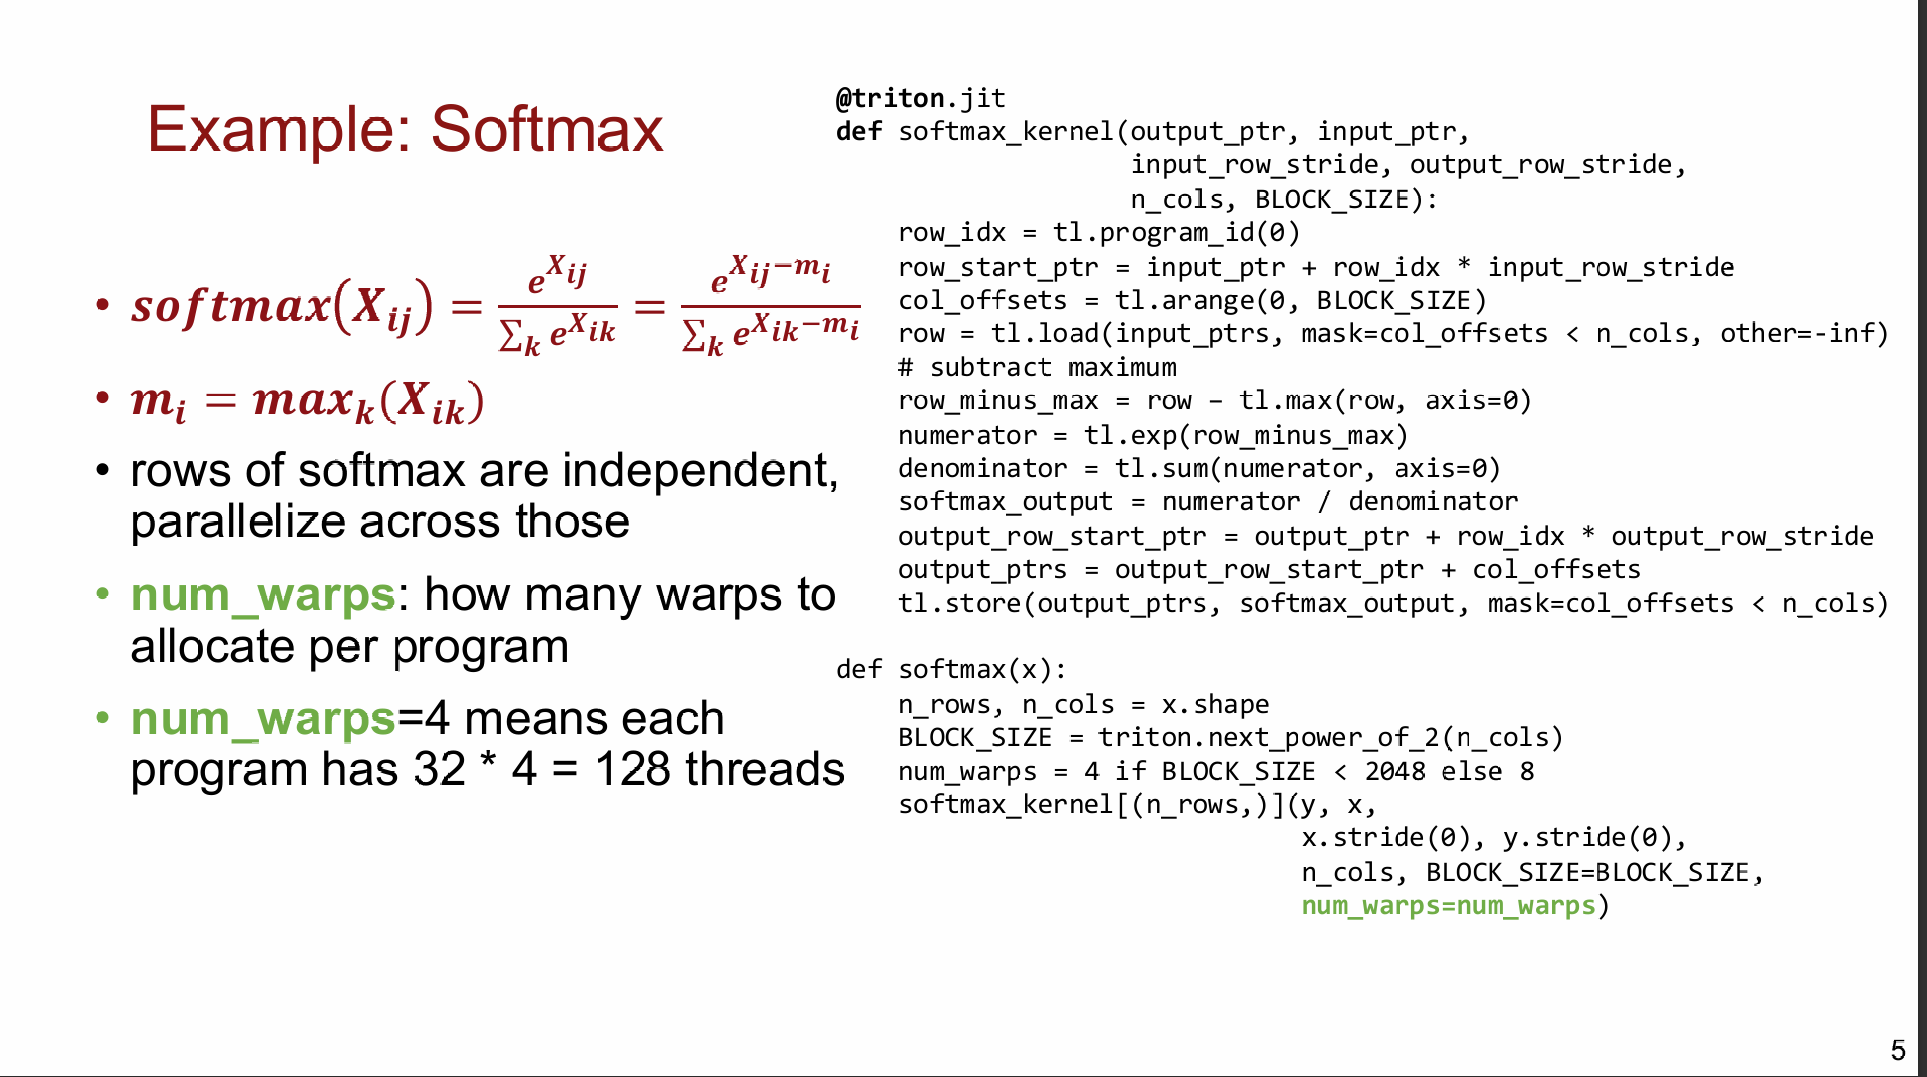
以 Softmax 为例,考虑对矩阵 X 的每一行做 Softmax,每行之间的运算是独立可并行的。
@triton.jit
def softmax_kernel(output_ptr, input_ptr,
                   input_row_stride, output_row_stride,
                   n_cols, BLOCK_SIZE):
output_ptr 和 input_ptr 是指向输出和输入矩阵的指针,input_row_stride 和 output_row_stride 是行跨度,n_cols 是列数,BLOCK_SIZE 是块大小。对应到函数调用点:
def softmax(x):
    n_rows, n_cols = x.shape
    BLOCK_SIZE = triton.next_power_of_2(n_cols)
    num_warps = 4 if BLOCK_SIZE < 2048 else 8
    softmax_kernel[(n_rows,)](y, x,
                              x.stride(0), y.stride(0),
                              n_cols, BLOCK_SIZE=BLOCK_SIZE,
                              num_warps=num_warps)
y 是输出矩阵,x 是输入矩阵。triton.next_power_of_2(n_cols) 取不小于 n_cols 的最小 2 的幂次方作为数据块大小。num_warps 是给每个数据块分配的线程束数。x.stride(0) 是输入矩阵的行跨度。
row_idx = tl.program_id(0)
row_start_ptr = input_ptr + row_idx * input_row_stride
col_offsets = tl.arange(0, BLOCK_SIZE)
定位行号 row_idx,计算该行的起始指针 row_start_ptr,生成列偏移量 col_offsets。
row = tl.load(input_ptrs, mask=col_offsets < n_cols, other=-inf)加载整行数据。
row_minus_max = row - tl.max(row, axis=0)      # ① 减行最大值
numerator     = tl.exp(row_minus_max)          # ② 逐元素 exp
denominator   = tl.sum(numerator, axis=0)      # ③ 行内求和 → 一个标量
softmax_output = numerator / denominator       # ④ 逐元素相除
进行 Softmax 计算,先减去行最大值防止溢出,然后逐元素取指数,再求和得到分母,最后逐元素相除得到 Softmax 输出。
output_row_start_ptr = output_ptr + row_idx * output_row_stride
output_ptrs = output_row_start_ptr + col_offsets
tl.store(output_ptrs, softmax_output, mask=col_offsets < n_cols)
写回输出矩阵。
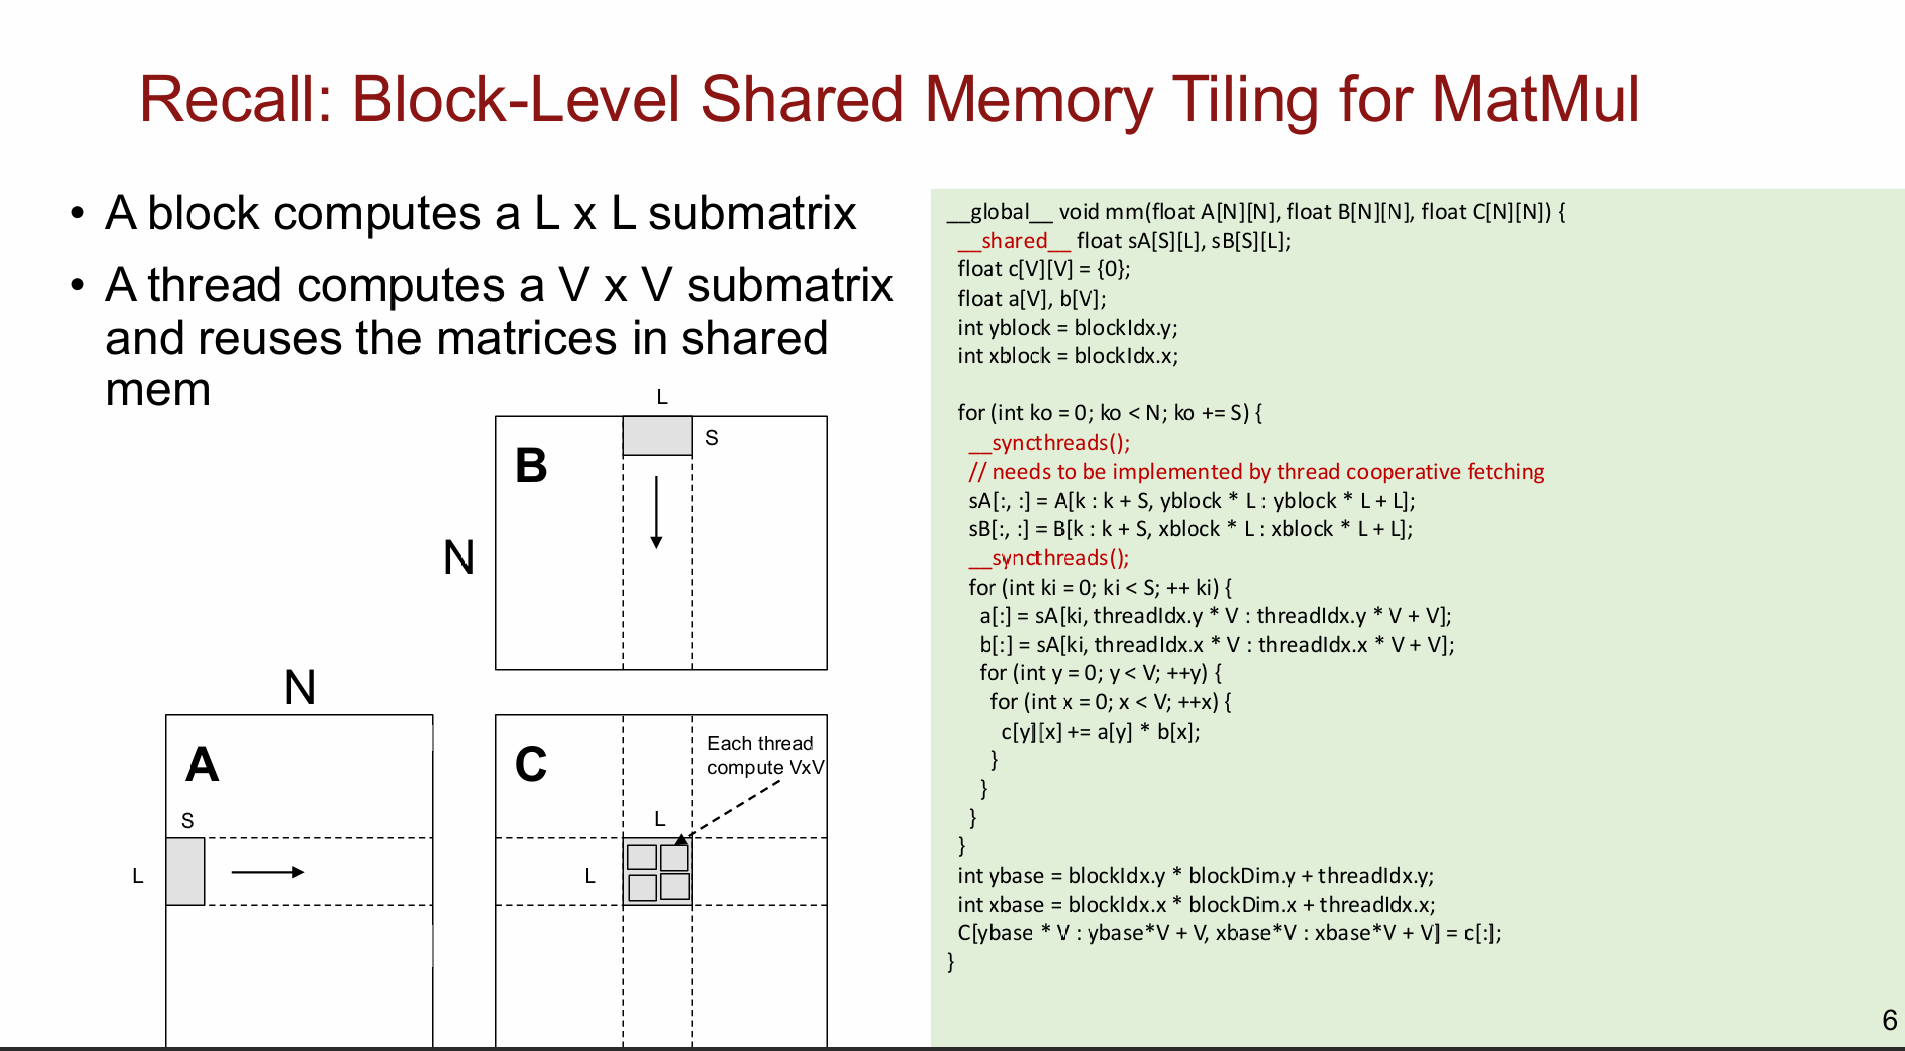
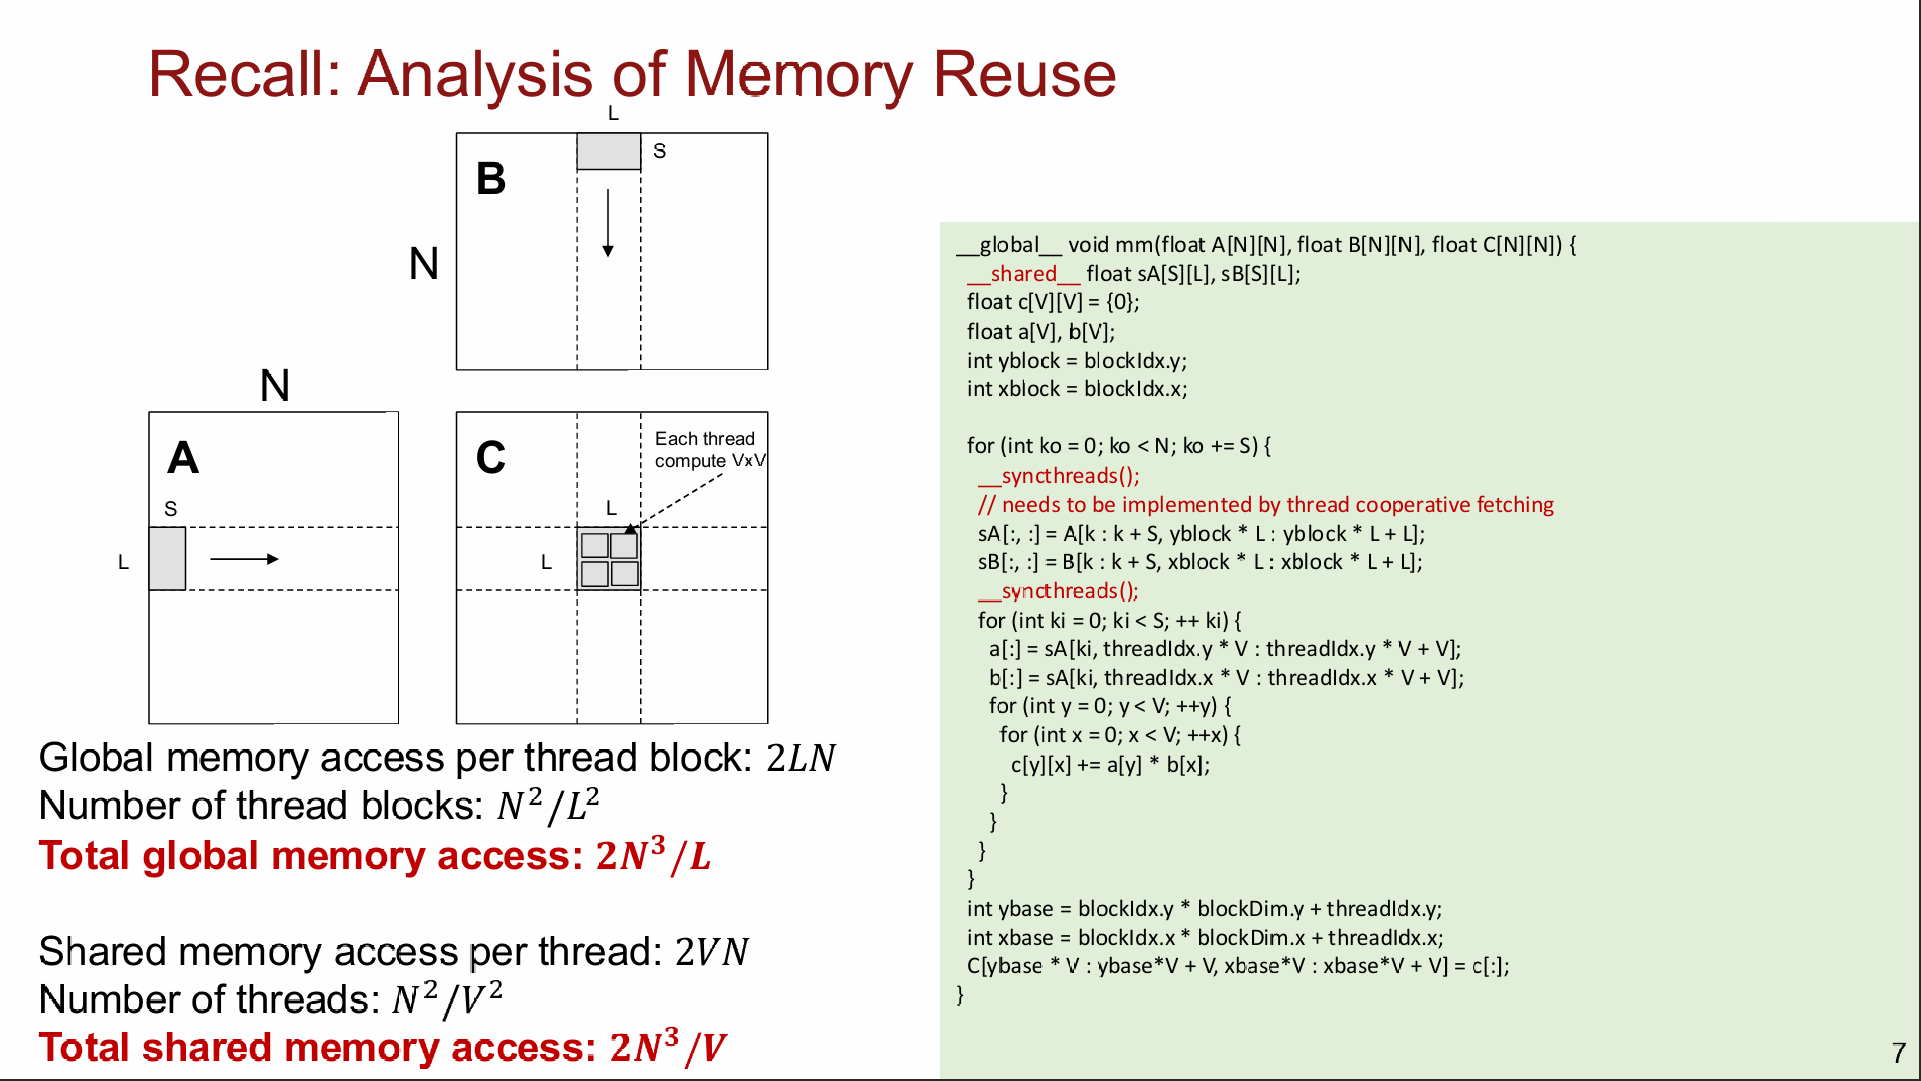
回顾之前我们做矩阵乘法是如何利用 Shared Memory 的:每次把 A 和 B 个矩阵的一块
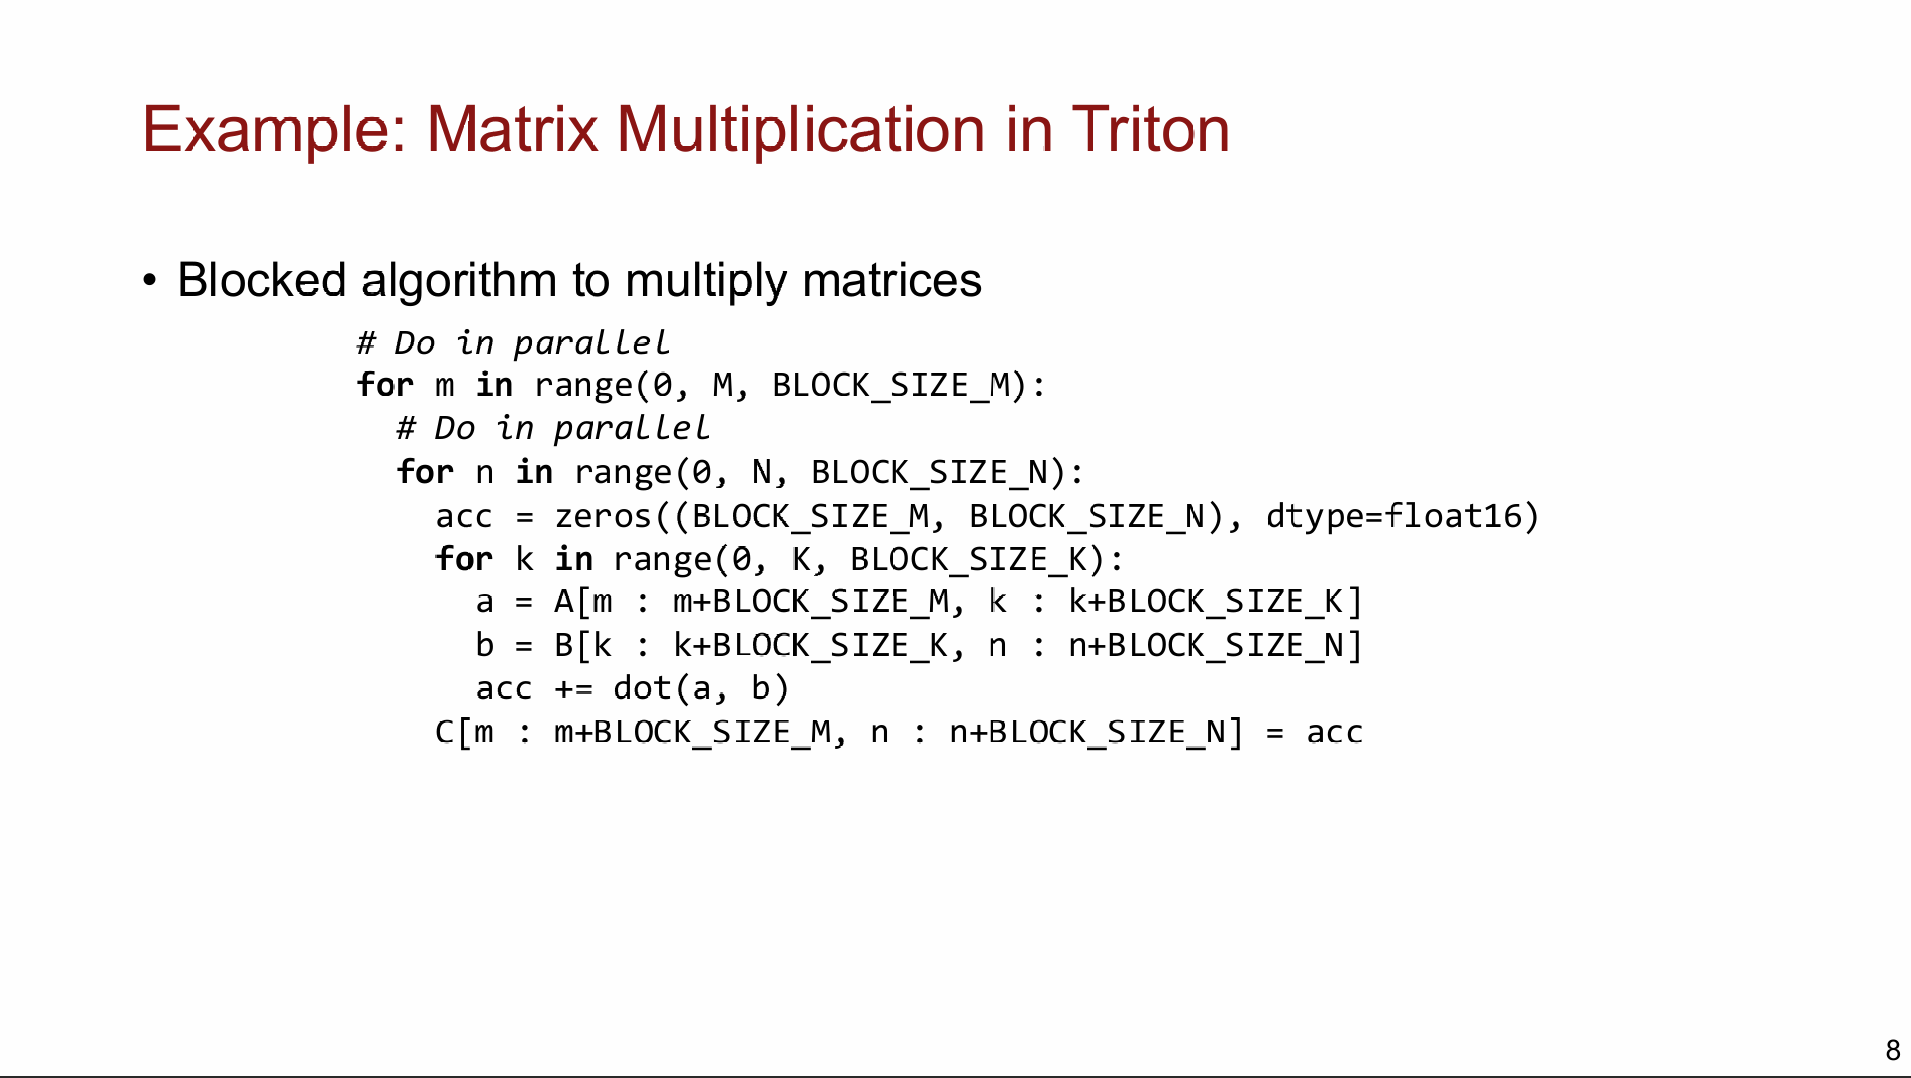
现在回到基于数据分块的视角,用伪代码实现同样的矩阵乘法。
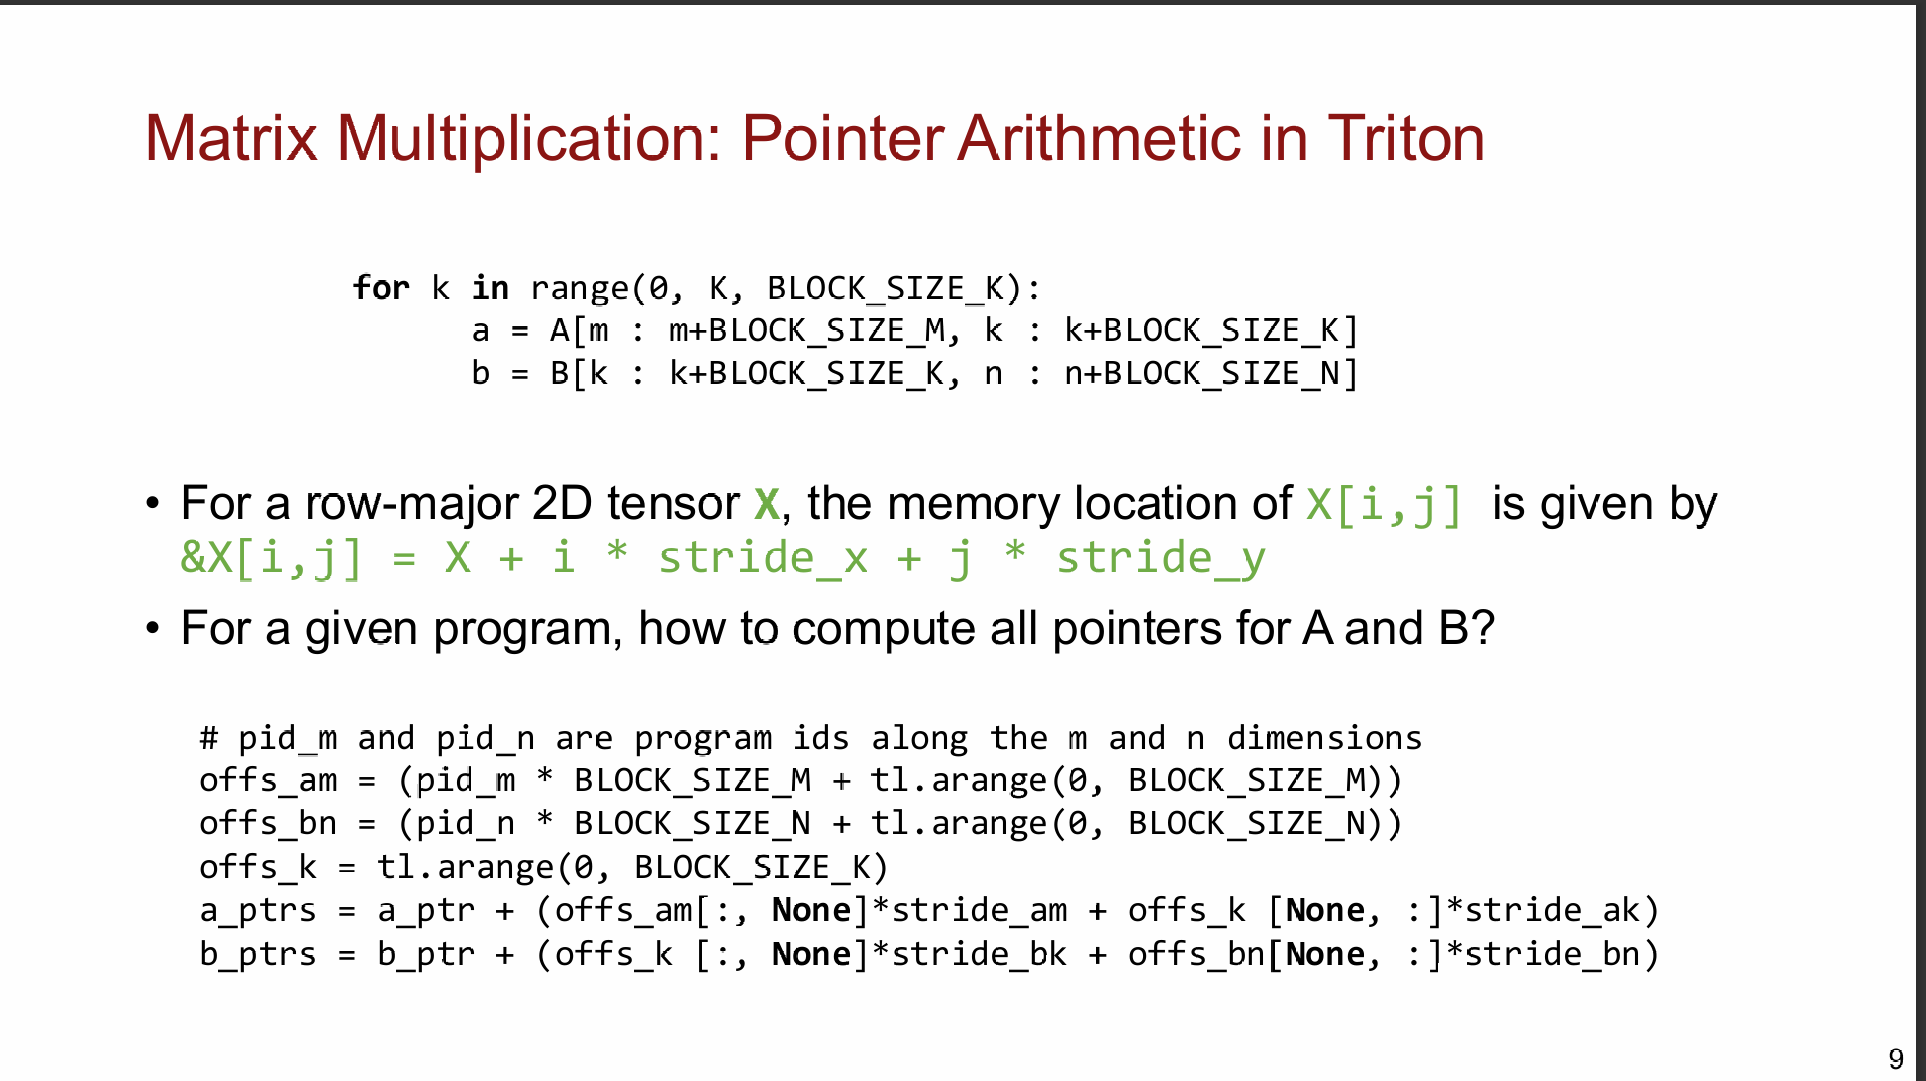
这一页关心怎么在 Triton 中实现上述伪代码中的直接取一个数据块的操作。
offs_am = (pid_m * BLOCK_SIZE_M + tl.arange(0, BLOCK_SIZE_M))
offs_bn = (pid_n * BLOCK_SIZE_N + tl.arange(0, BLOCK_SIZE_N))
计算了当前数据块在 A 和 B 中的起始偏移量。
offs_k = tl.arange(0, BLOCK_SIZE_K)计算 0 ~ BLOCK_SIZE_K 的一组偏移量。
a_ptrs = a_ptr + (offs_am[:, None]*stride_am + offs_k [None, :]*stride_ak)
b_ptrs = b_ptr + (offs_k [:, None]*stride_bk + offs_bn[None, :]*stride_bn)
a_ptr 是 A 矩阵的起始地址。offs_am[: None] 把当前数据块在矩阵 A 中的行偏移量扩展为二维数组,offs_k 把列维度上的偏移量扩展为二维数组,二者相加得到 A[m : m + BLOCK_SIZE_M, k : k + BLOCK_SIZE_K] 这块数据的全局偏移量。b_ptrs 的计算类似。
在考虑完怎么取一个块之后,我们要深入到执行顺序上,即 C 的哪一个数据块被先计算,因为这和 L2 Cache 的使用效率有关。我们希望在计算一个数据块时,尽量让 A 和 B 的数据块都在 L2 Cache 中,这样可以减少从全局内存加载的次数。
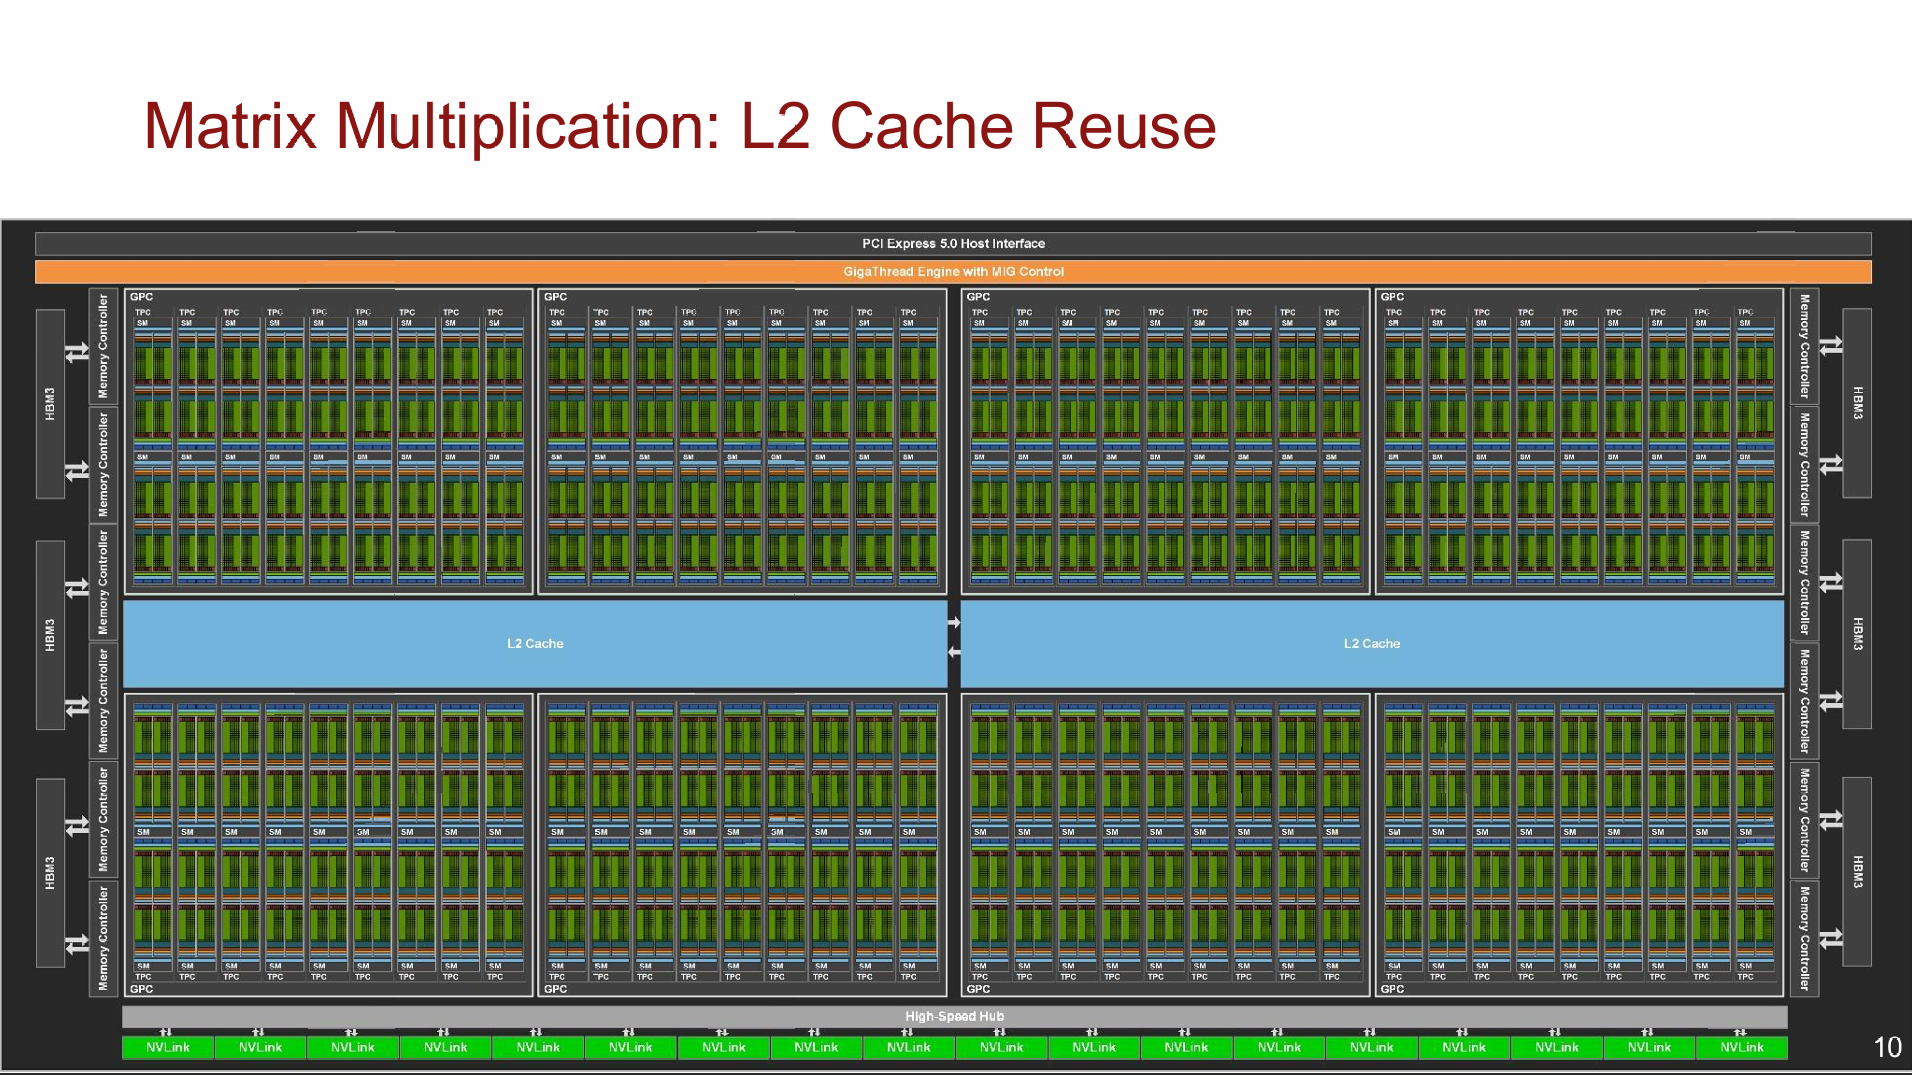
在 Triton 的矩阵乘法教程中,输出矩阵 C 被切成 num_pid_m × num_pid_n 个块(tile),每个 GPU 程序负责计算其中一个 BLOCK_M × BLOCK_N 大小的块:pid_m 决定读 A 的哪一段行,pid_n 决定读 B 的哪一段列,两者合起来定位要写入 C 的那块输出。但 GPU 启动 kernel 时并不会给程序发二维坐标——每个程序只拿到一个一维编号 pid(0, 1, 2, ...),启动的也是一维网格。于是 kernel 开头需要几行代码把 pid 翻译成块坐标 (pid_m, pid_n),而且这段翻译被刻意设计成一种对 L2 缓存友好的顺序。
以 9×9 的块网格、GROUP_SIZE_M=3 为例,此时 num_pid_in_group = 3×9 = 27,即每组 27 个程序、负责连续的 3 行块。
group_id = pid // 27:我在第几个"组"。pid 0~26 是组 0,27~53 是组 1,54~80 是组 2。first_pid_m = group_id * 3:我这组从全局第几行开始。组 0 从第 0 行起,组 1 从第 3 行起,组 2 从第 6 行起。它是"组内坐标 → 全局坐标"的平移量,类似段基址。如果删掉它,pid % 3永远只能得出 0、1、2,三个组会全挤在第 0~2 行把同样的块算三遍,第 3~8 行则无人处理——模拟结果是 81 个块只覆盖了 27 个。pid_m = first_pid_m + pid % 3:组内行号(0~2 循环)加上组的起始行,得到全局行号。pid_n = (pid % 27) // 3:拆成两步看。第一步pid % 27得到组内编号(0~26);第二步// 3从编号中拆出列号。必须先取余是因为 pid 是全局编号:组 1 从 pid=27 开始,若直接写27 // 3会得到"第 9 列",而列只有 0~8,直接越界。取余相当于把编号重置回组内,让列号从 0 重新数起。
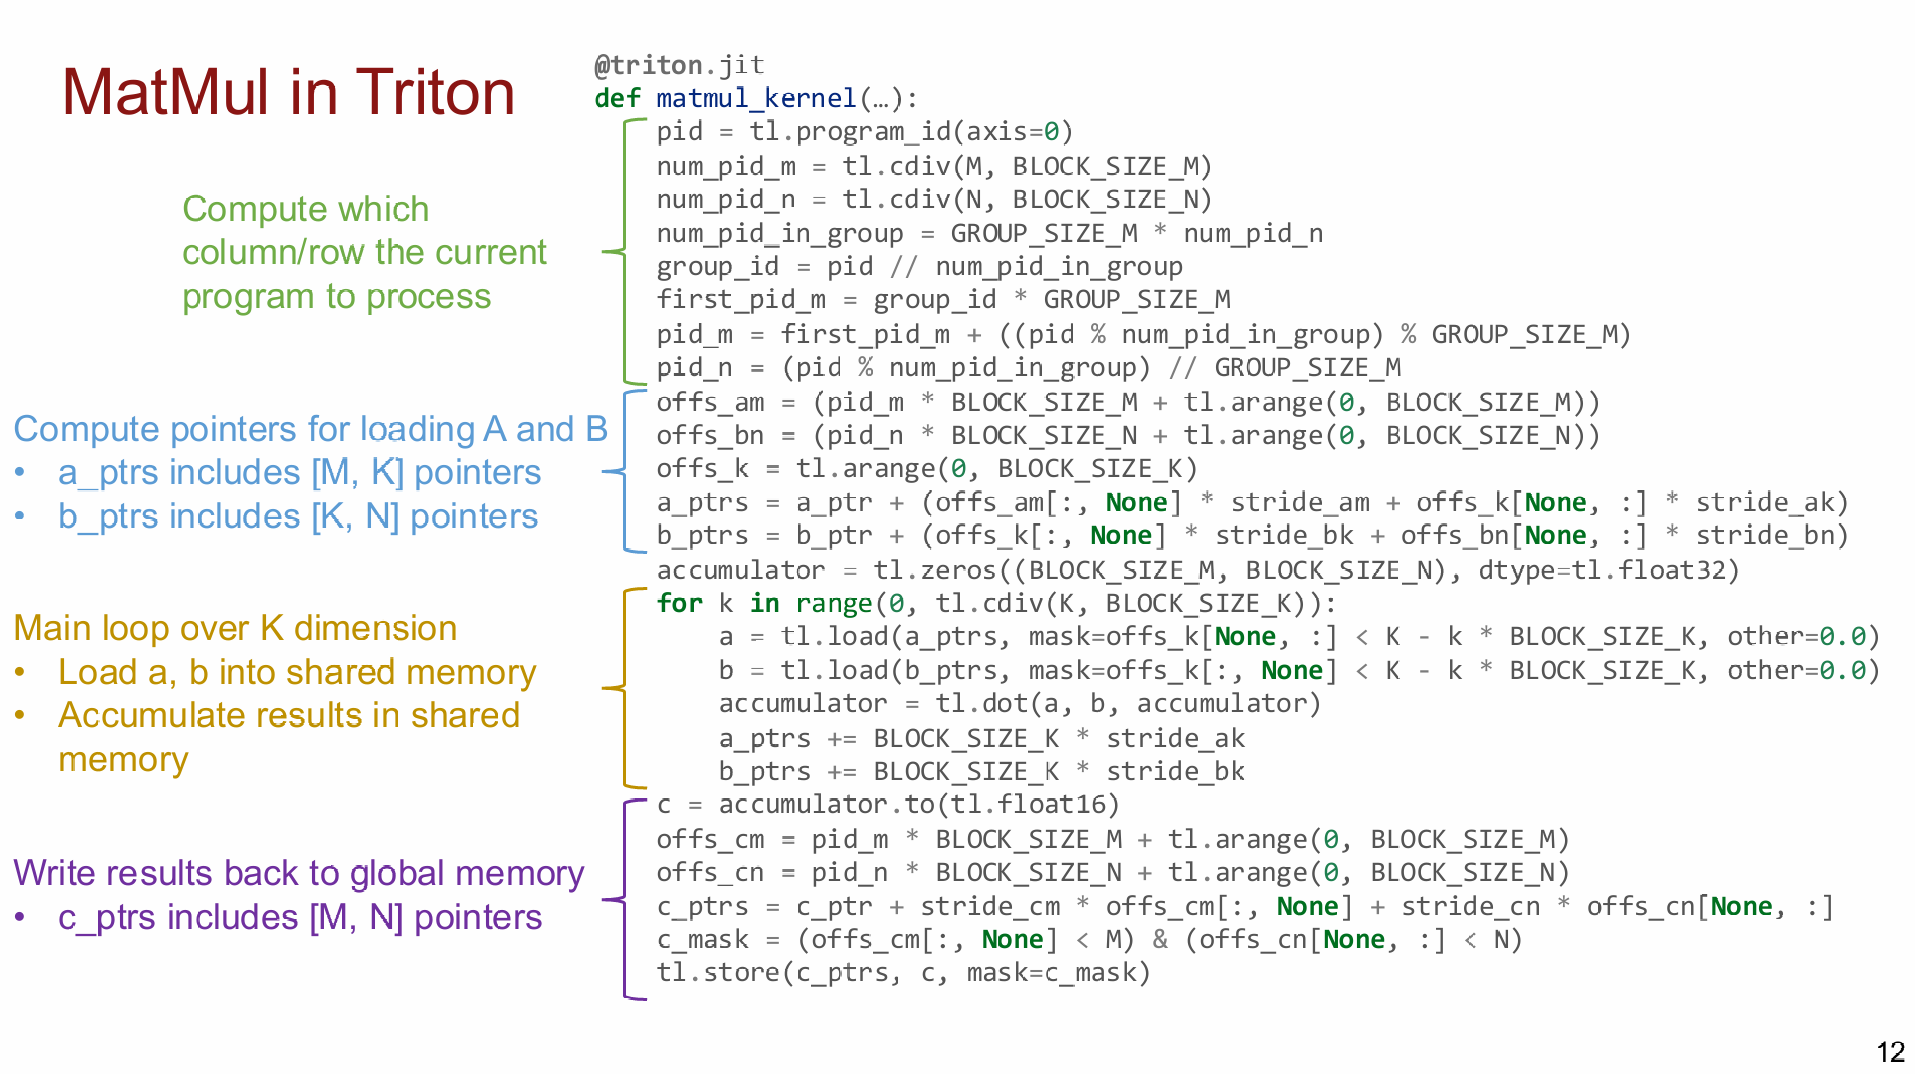
结合起来这就是基于 Triton 的一个 matmul kernel 的完整实现。
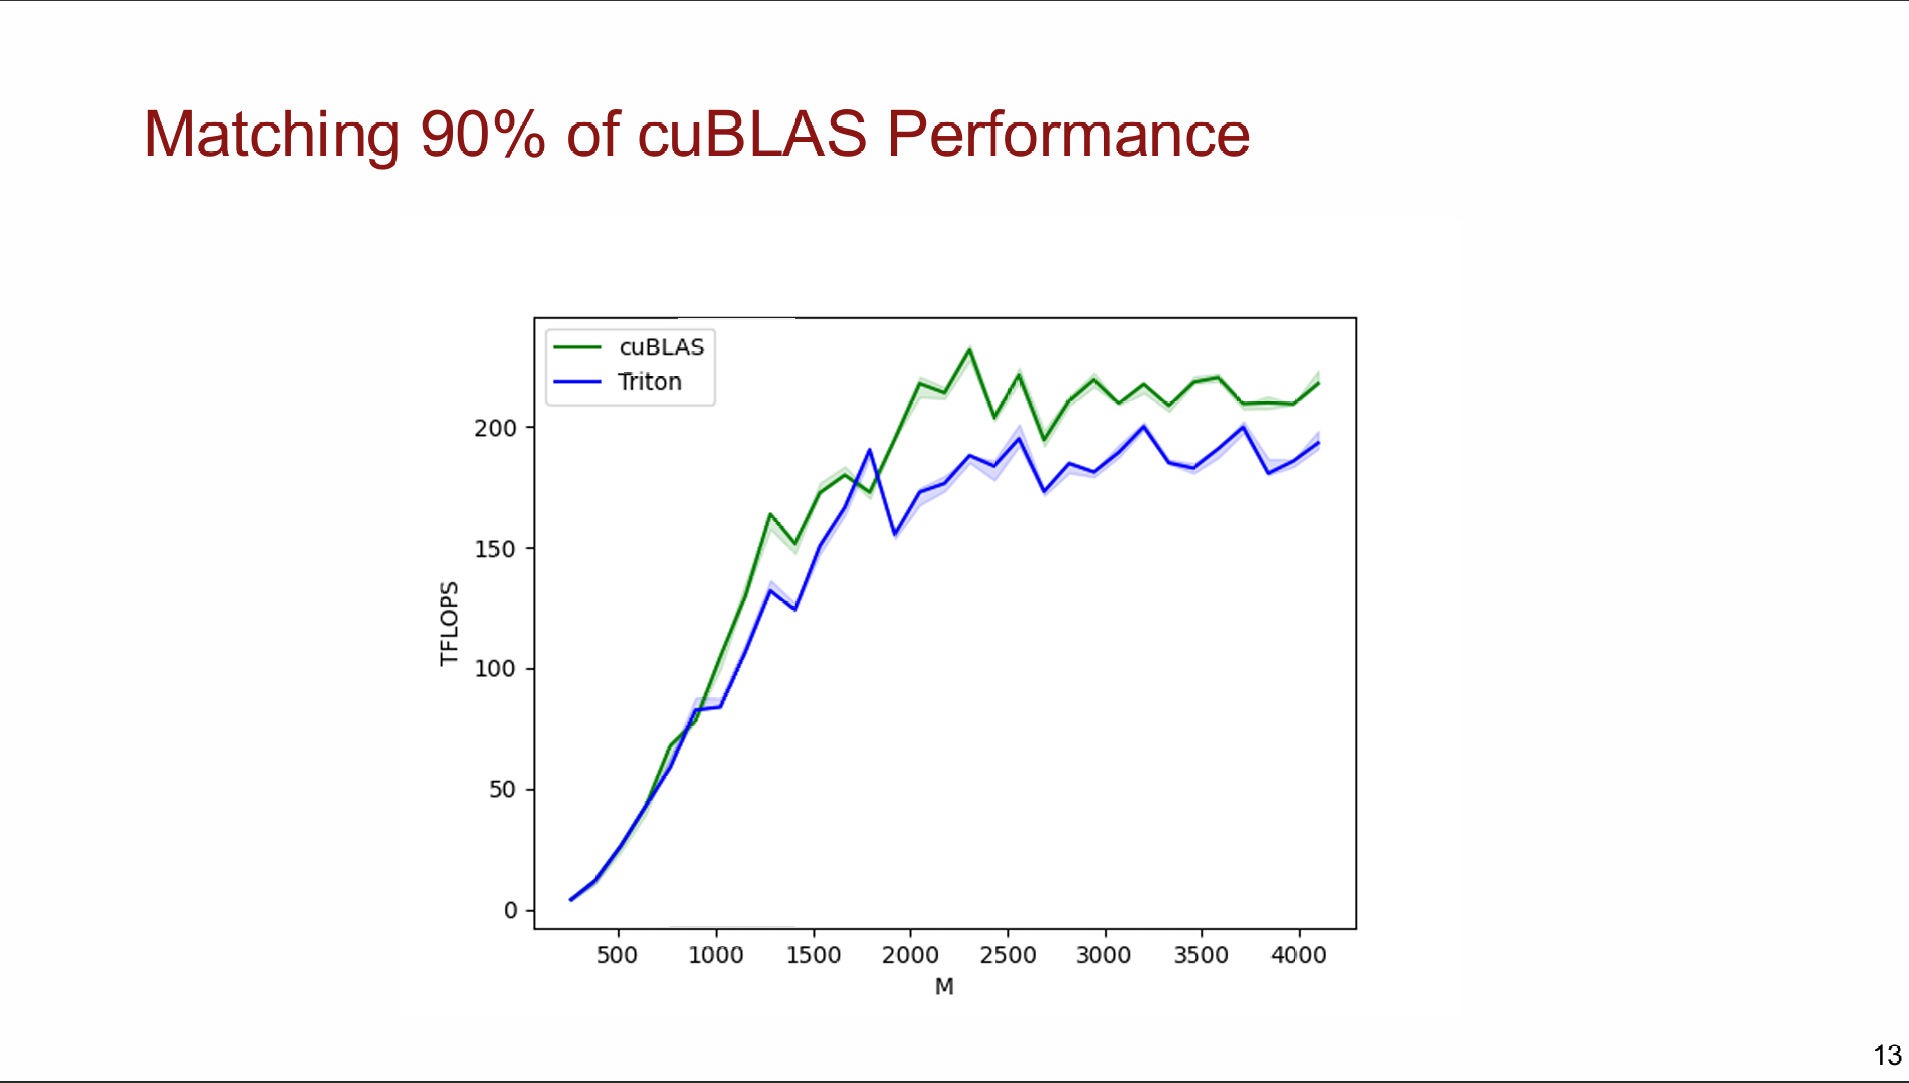
手写的 Triton kernel 达到了 NVIDIA 官方高度优化库 cuBLAS 约 90% 的性能。
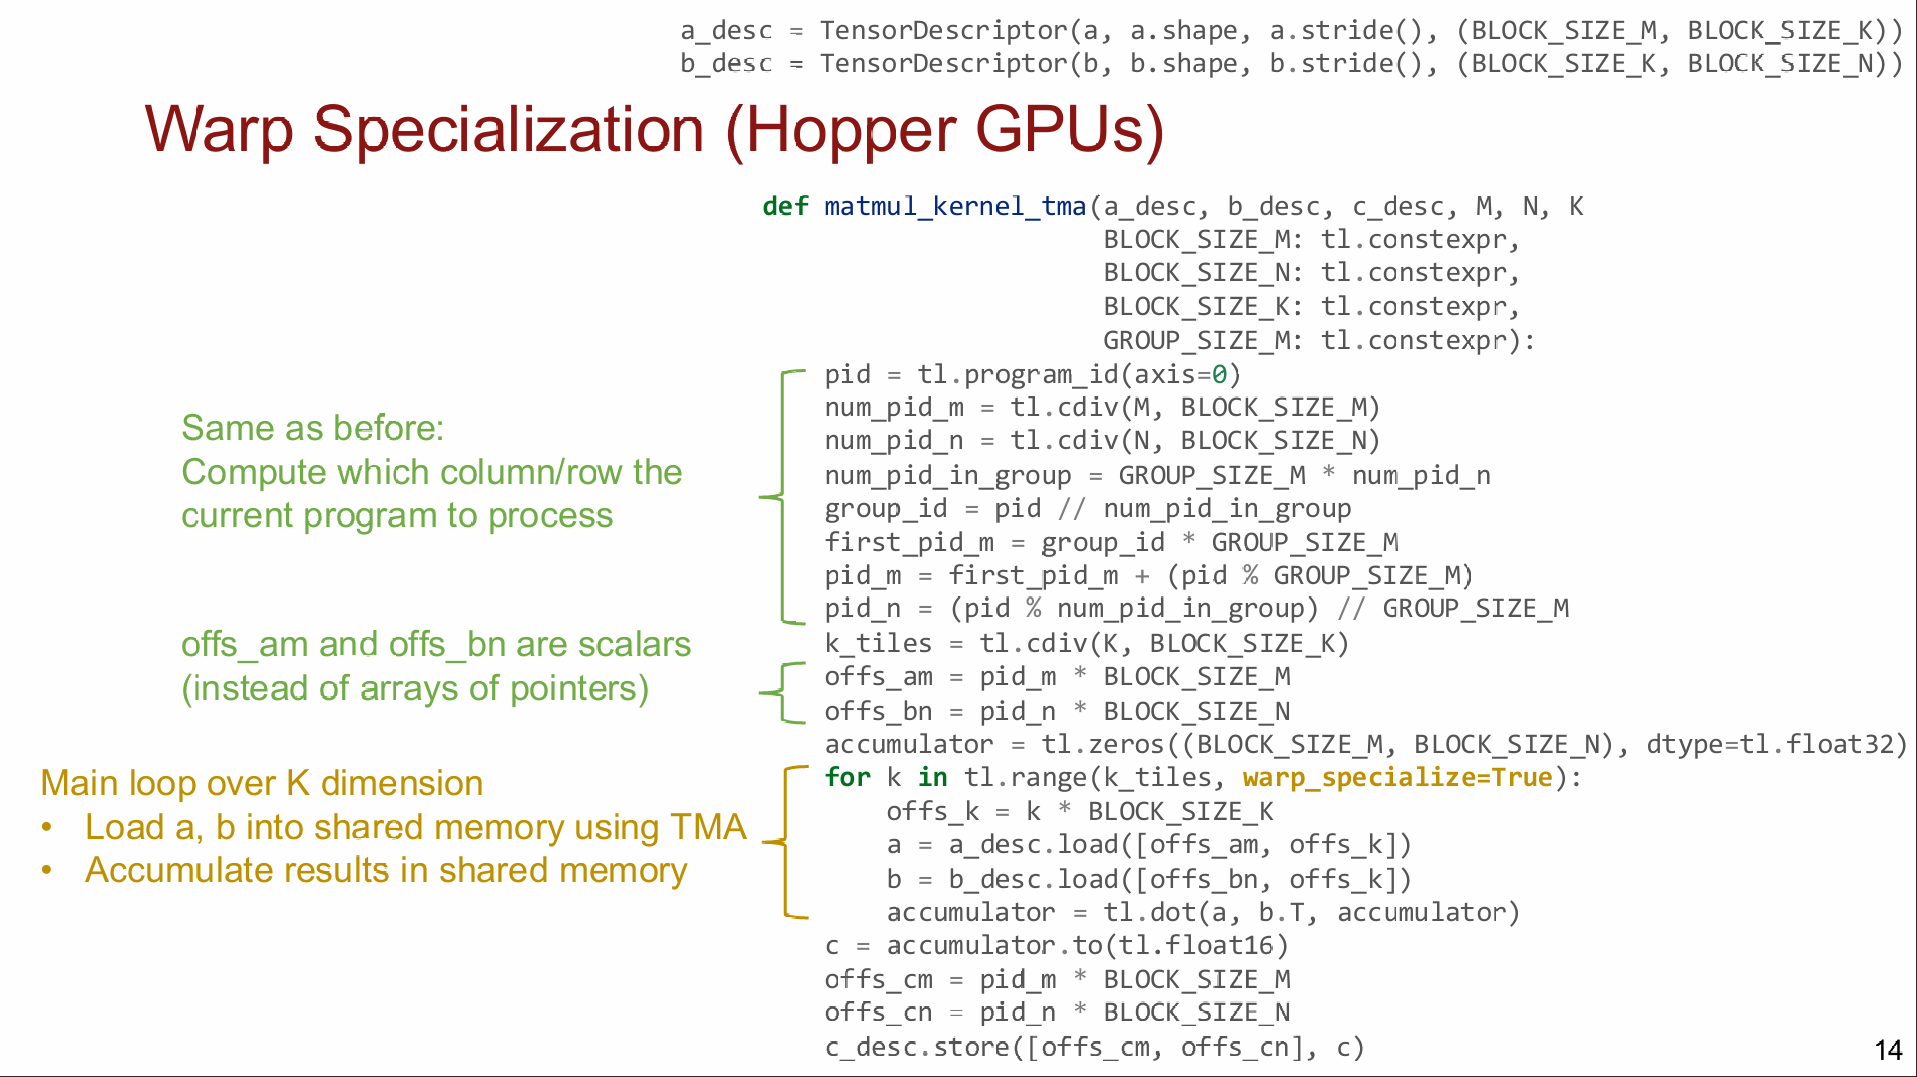
在 Hopper 架构上,Triton 的 matmul kernel 可以利用 TMA(Tensor Memory Access)特性,同时实现 Wrap Specialization。TensorDescriptor 是 Triton 对 Hopper 硬件单元 TMA 的封装。先前的写法要程序员手动算出整块地址再 tl.load,在启用 TMA 后,Triton 会自动把矩阵的行列信息传给硬件单元,让硬件直接按矩阵的行列信息去加载数据块。
Wrap Specialization 的启用更简单,只需要增加一个 wrap_specialization=True 的参数,Triton 会自动把 Wrap 做流水线化。
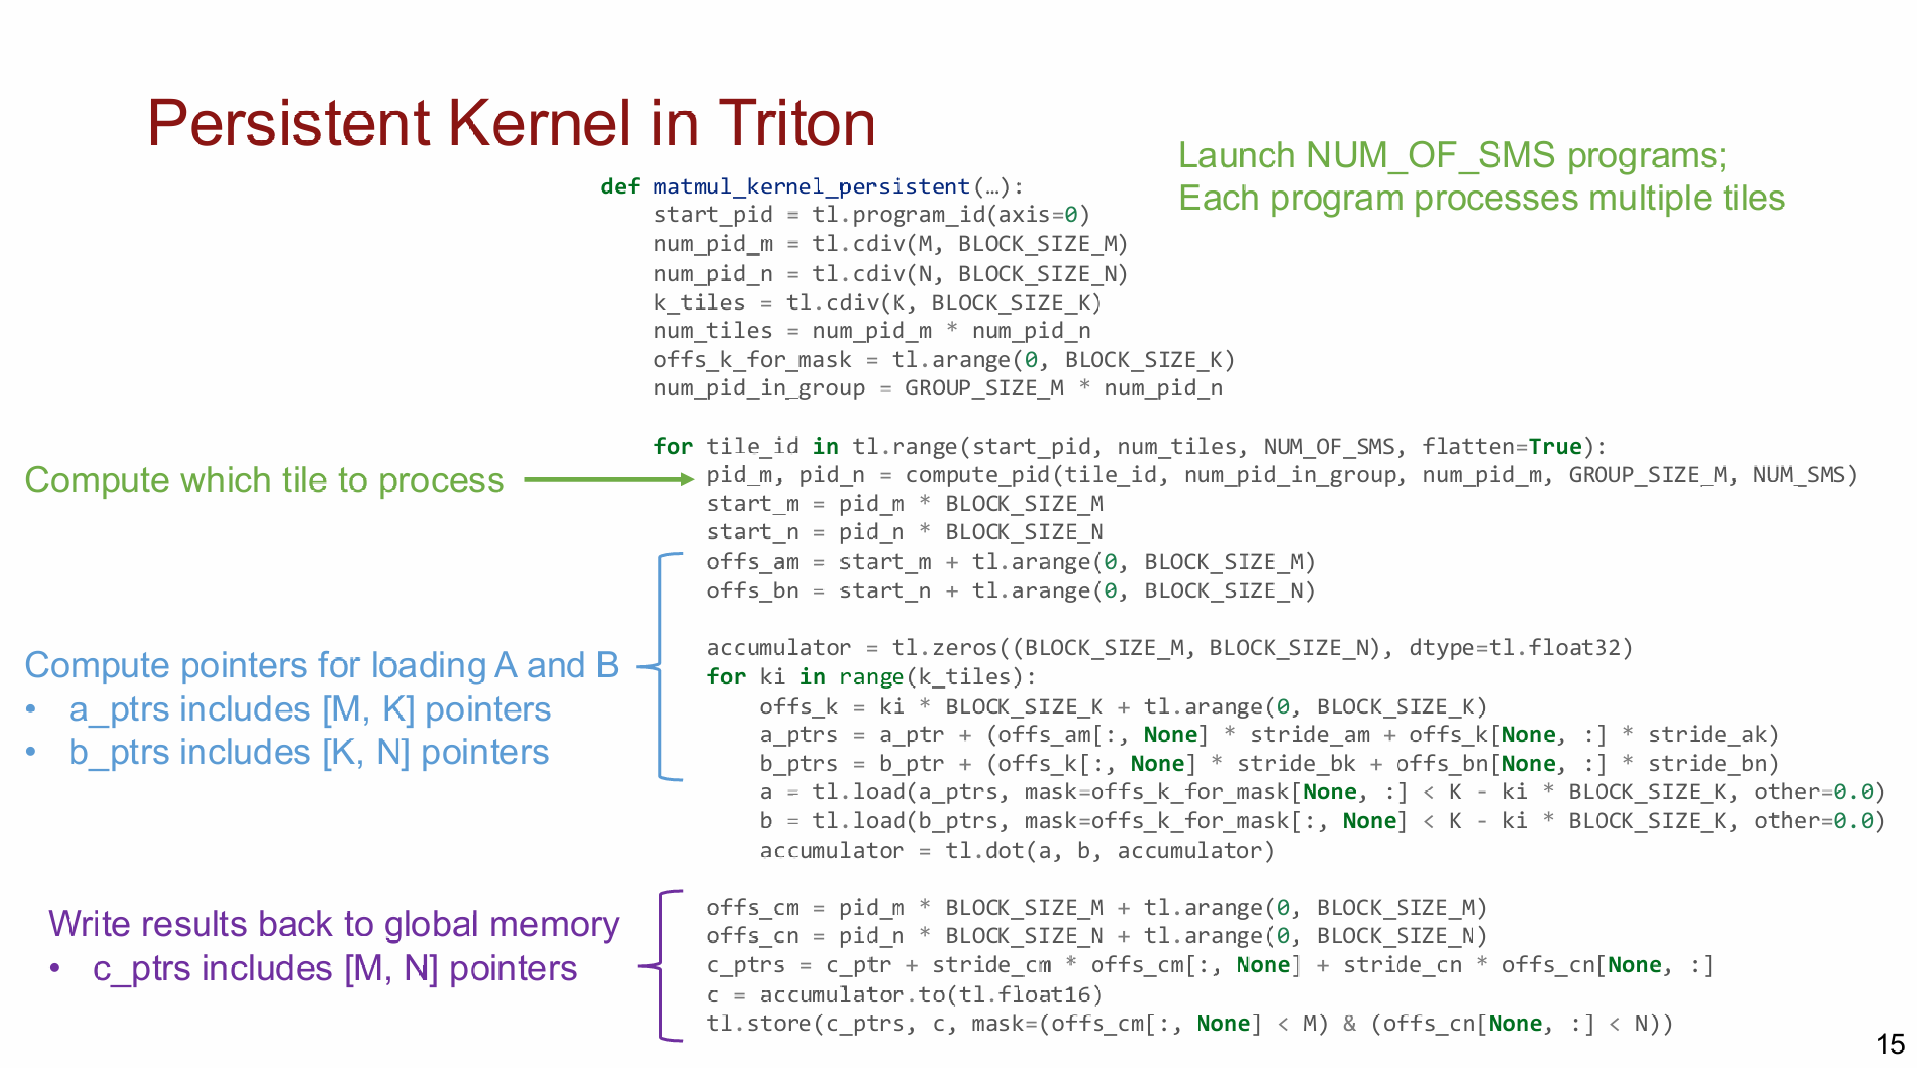
这一页讲的是 Triton 中的持久化内核(Persistent Kernel):传统矩阵乘 kernel 要为每个 tile(C 的一个分块)启动一个 program,算完即退出,导致启动(prologue)和收尾(epilogue)的开销随 tile 数量增加;
持久化内核则只在 host 侧启动恰好等于 SM 数量(NUM_OF_SMS)个 program,每个 program 常驻 GPU,通过外层循环 for tile_id in tl.range(start_pid, num_tiles, NUM_OF_SMS, flatten=True) 动态领取任务——起点取自己的编号 start_pid,步长取 SM 总数,使得 8 个 program 分别处理 tile 0→8→16→…、1→9→17→…,谁算得快谁自动多干,天然实现负载均衡;
循环体内的 compute_pid 函数复用第 11 页的分组调度(grouped ordering)把 tile_id 映射成坐标,随后是与第 9 页如出一辙的经典指针算术(offs 向量 + [:,None]/[None,:] 广播构造 a_ptrs/b_ptrs,本页还补全了 K 维和 M/N 维的越界 mask),完成一次 dot 累加和写回后立刻回到循环领下一个 tile;配合 flatten=True 允许编译器做跨 tile 流水,让上一个 tile 的写回与下一个 tile 的装载重叠执行。
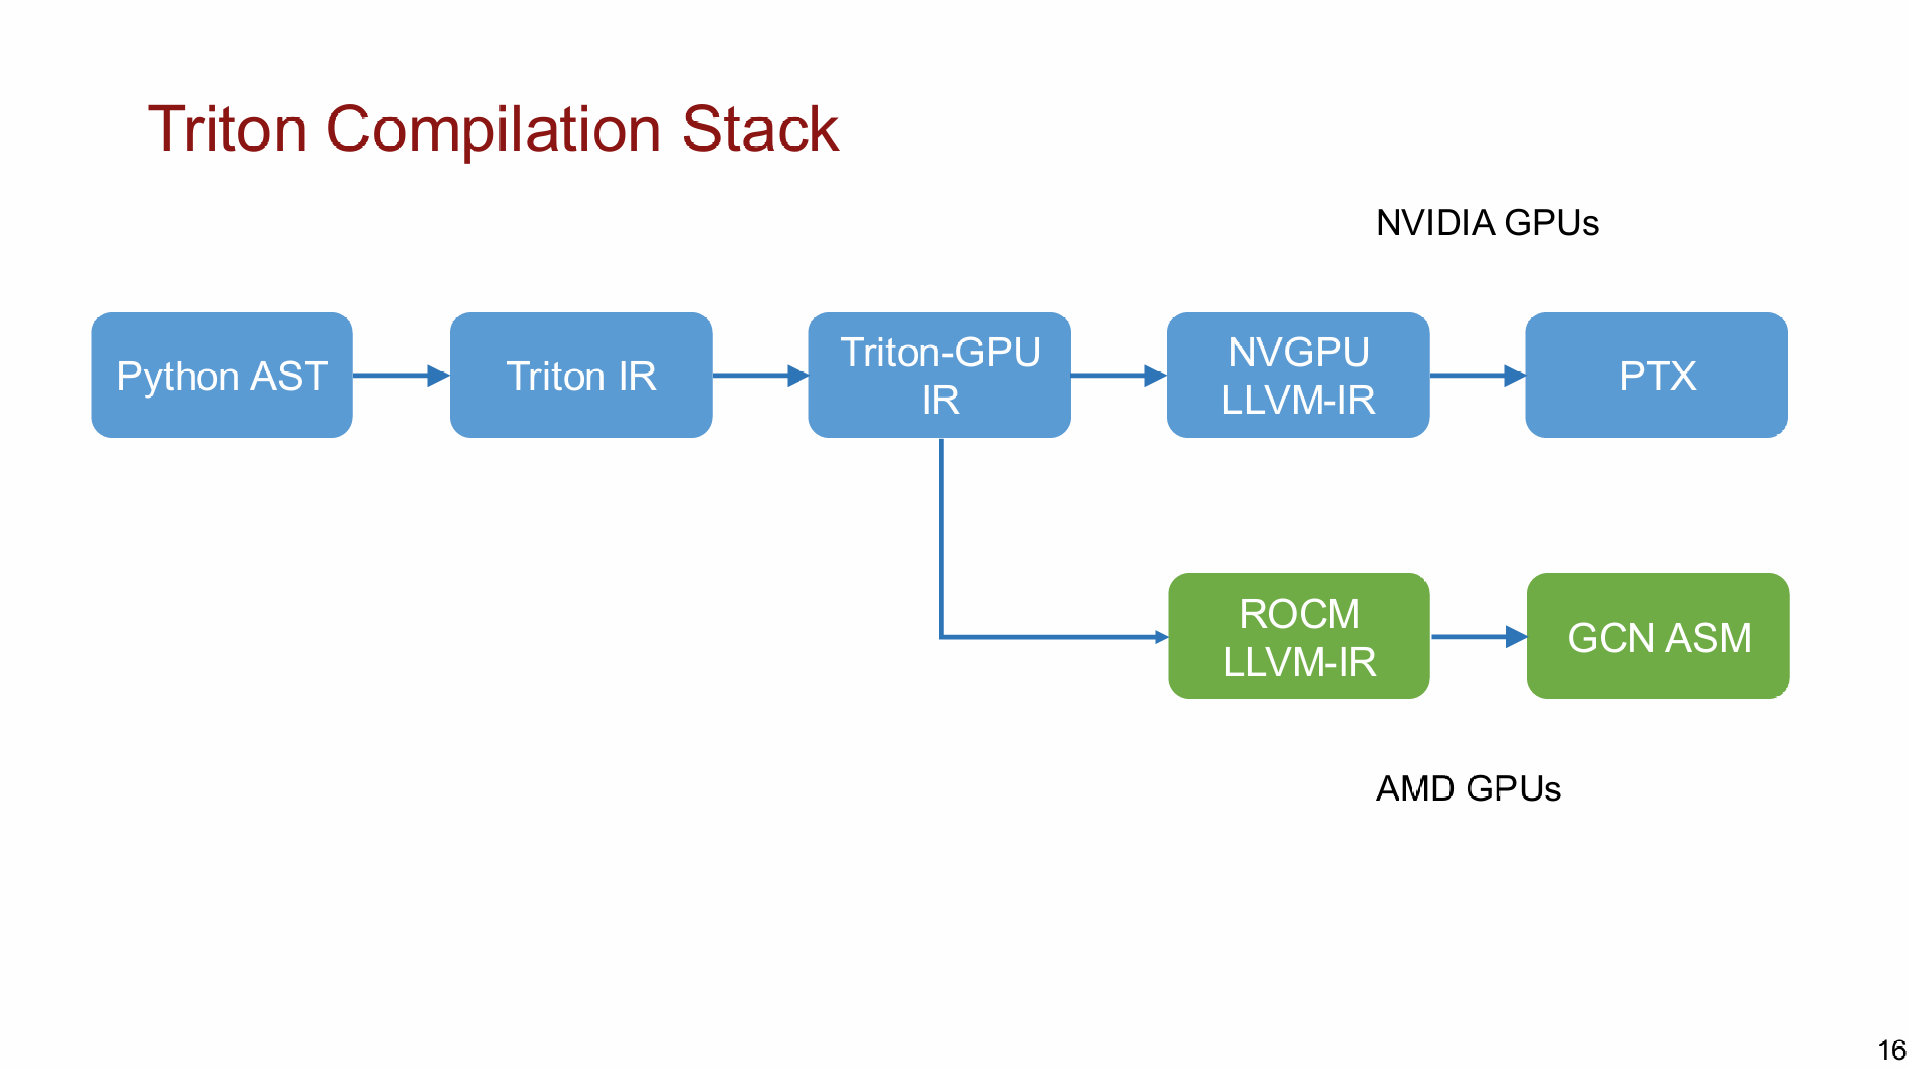
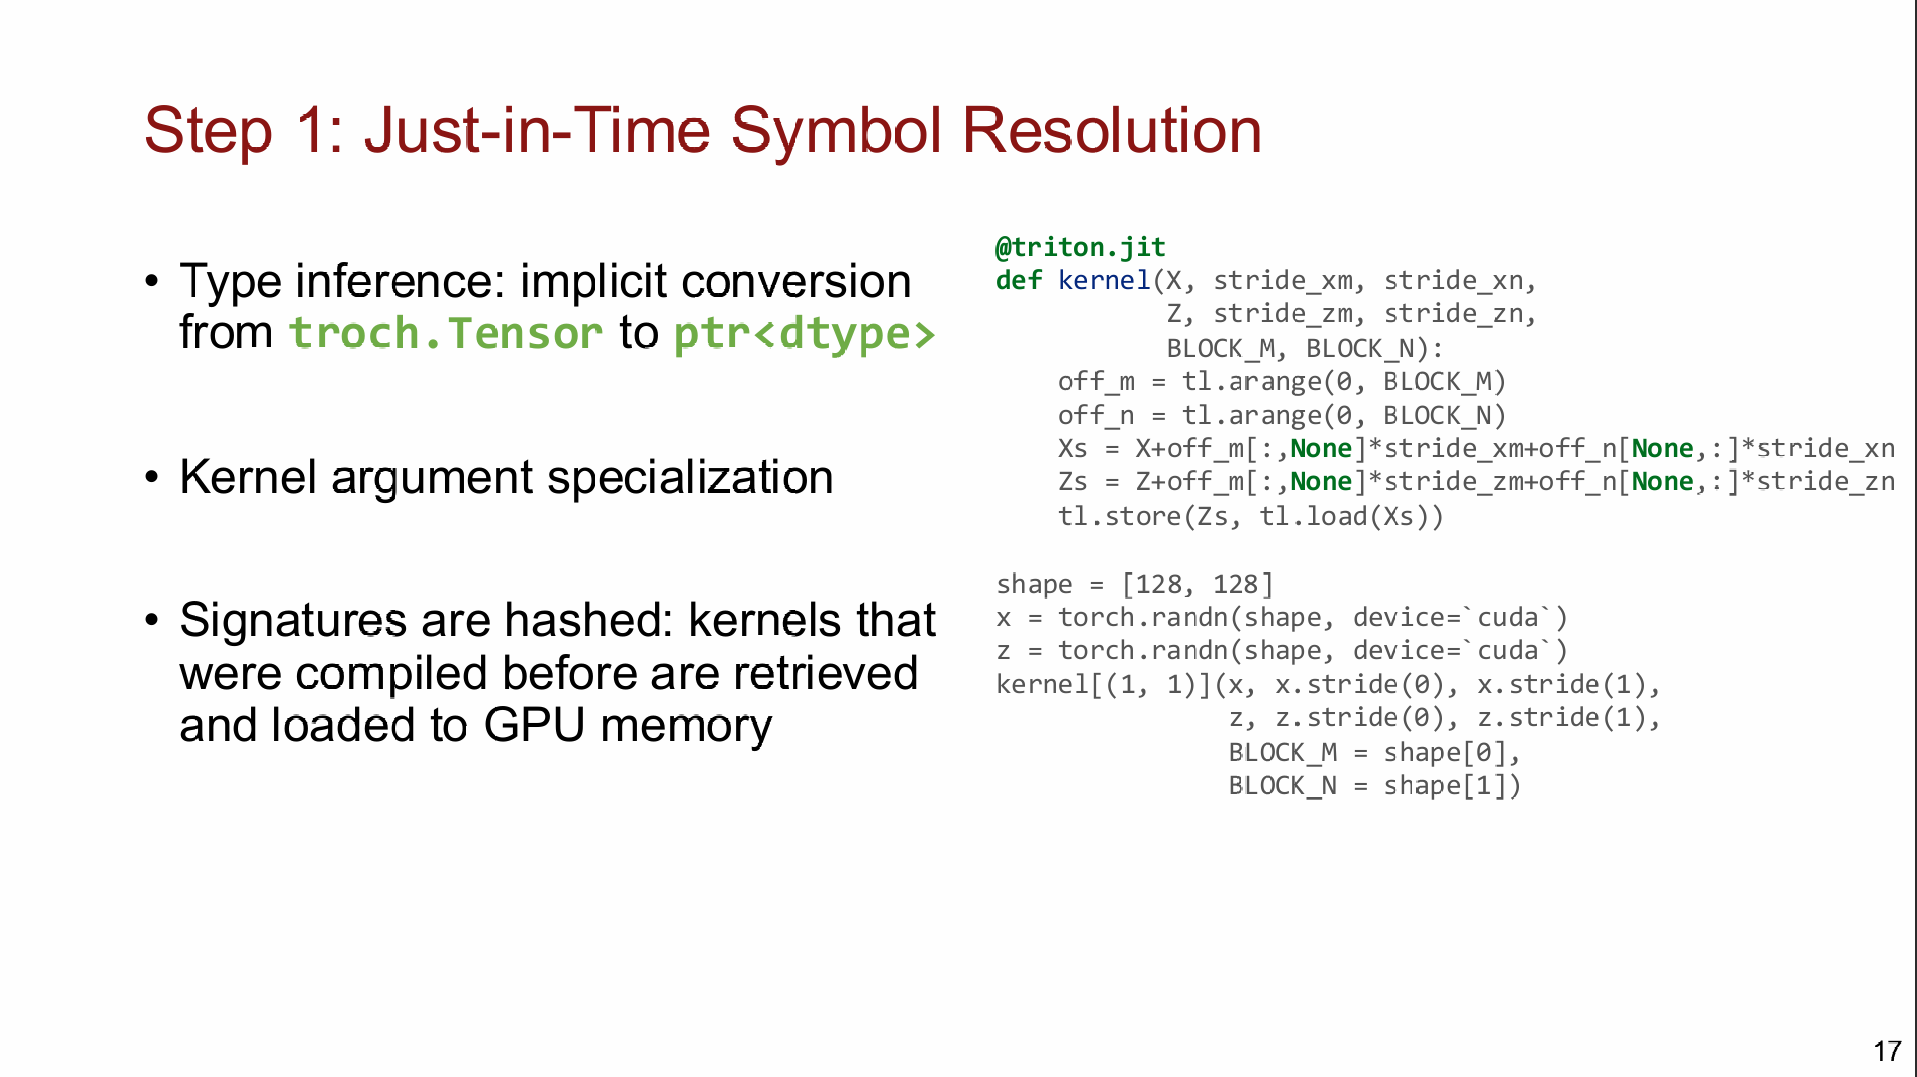
- 类型推理:边界处发生隐式转换:Triton 运行时取出张量的
data_ptr()(首元素地址)作为数值,并根据x.dtype自动推断出 kernel 内的类型; - Kernel 参数特化:并非所有参数都作为“运行时变量”传给 GPU,某些参数的值会被直接特化为编译时常量(constexpr),例如
BLOCK_SIZE、num_warps,这样 kernel 内的循环边界和分支条件就能在编译期确定,生成更高效的代码; - 对函数签名做哈希缓存:函数参数类型、特化的常量值和环境信息(Triton 版本、CUDA 版本、GPU 架构)共同决定 kernel 的唯一签名,Triton 会在第一次调用时编译 kernel 并缓存,后续调用直接复用。
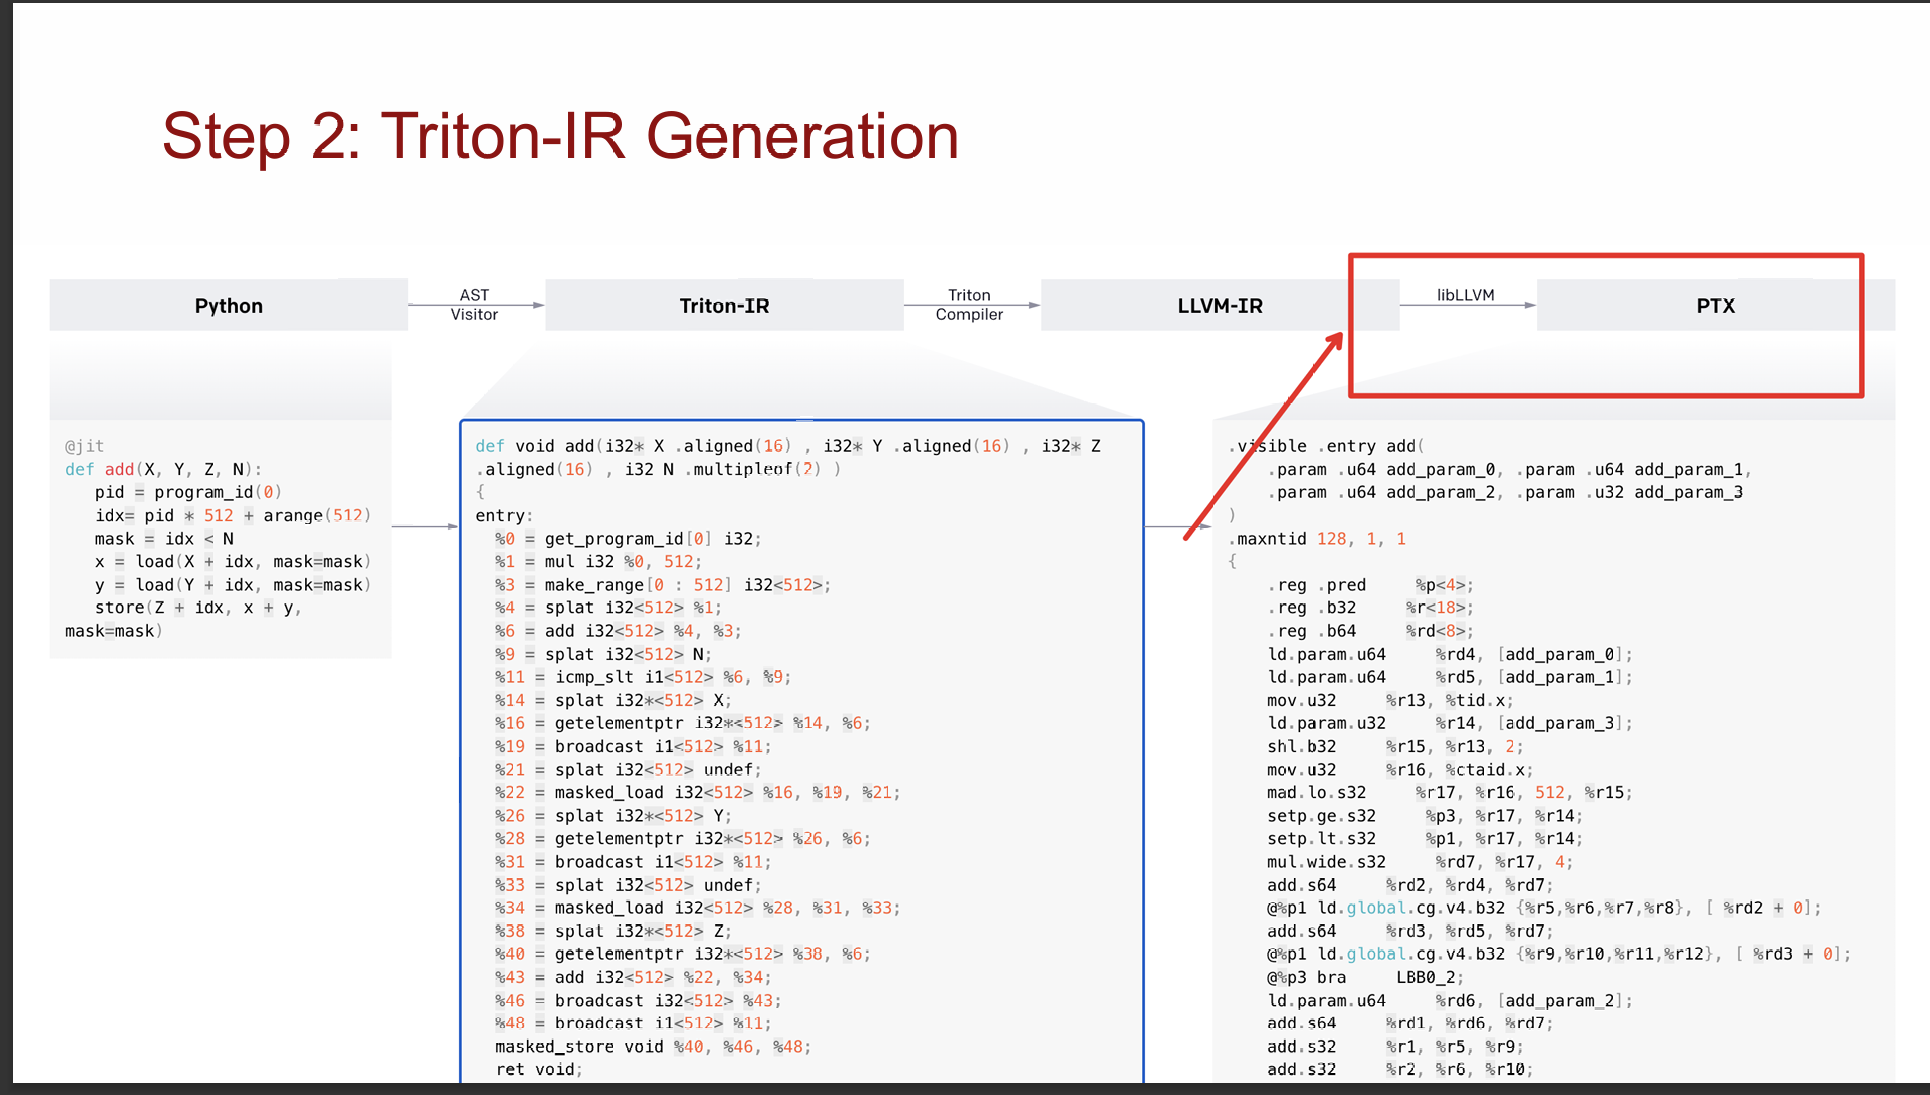
生成 Triton-IR。
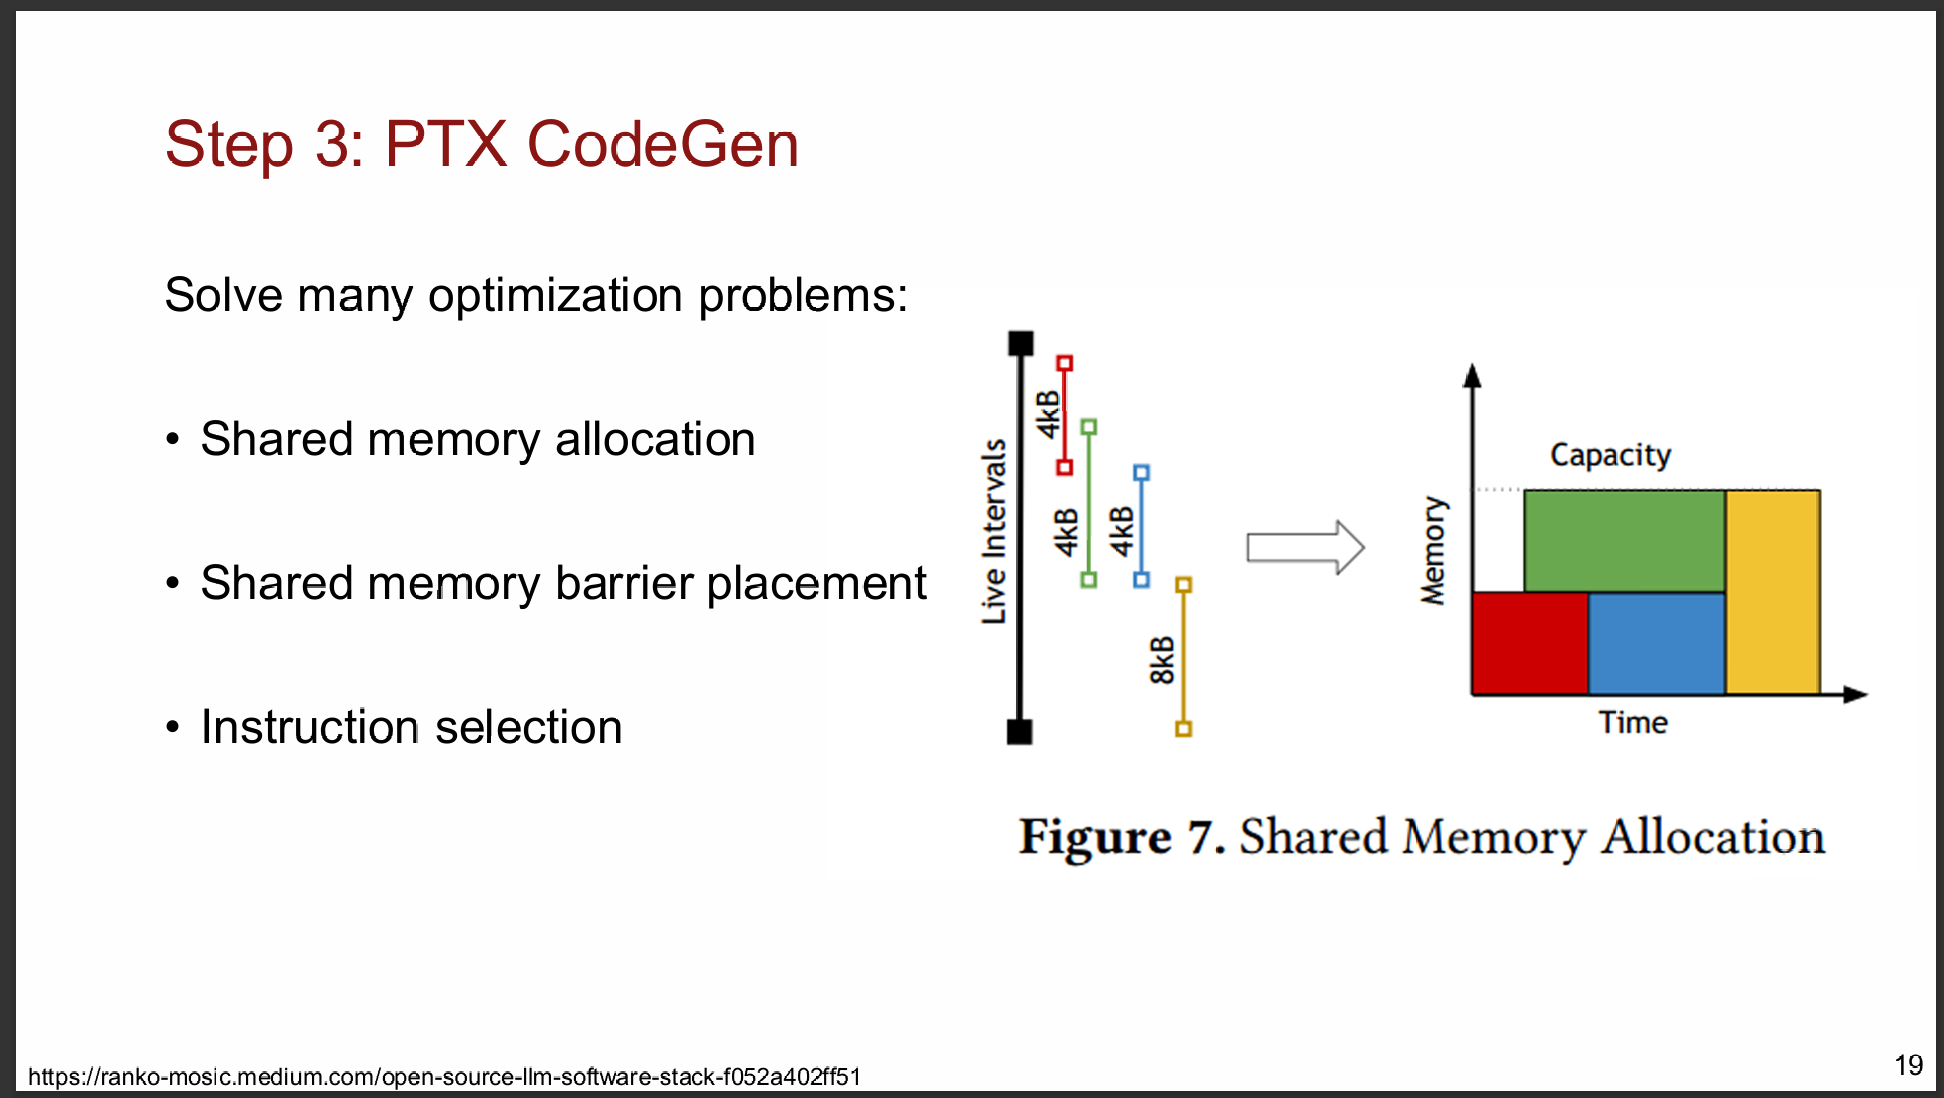
- 共享内存分配:把每个变量的活跃区间,即从首次写入到最后一次被读走的程序区间,画在时间轴上,然后做类似寄存器分配/区间图着色。
- 共享内存屏障:写共享内存和读共享内存之间必须插入必须的屏障。
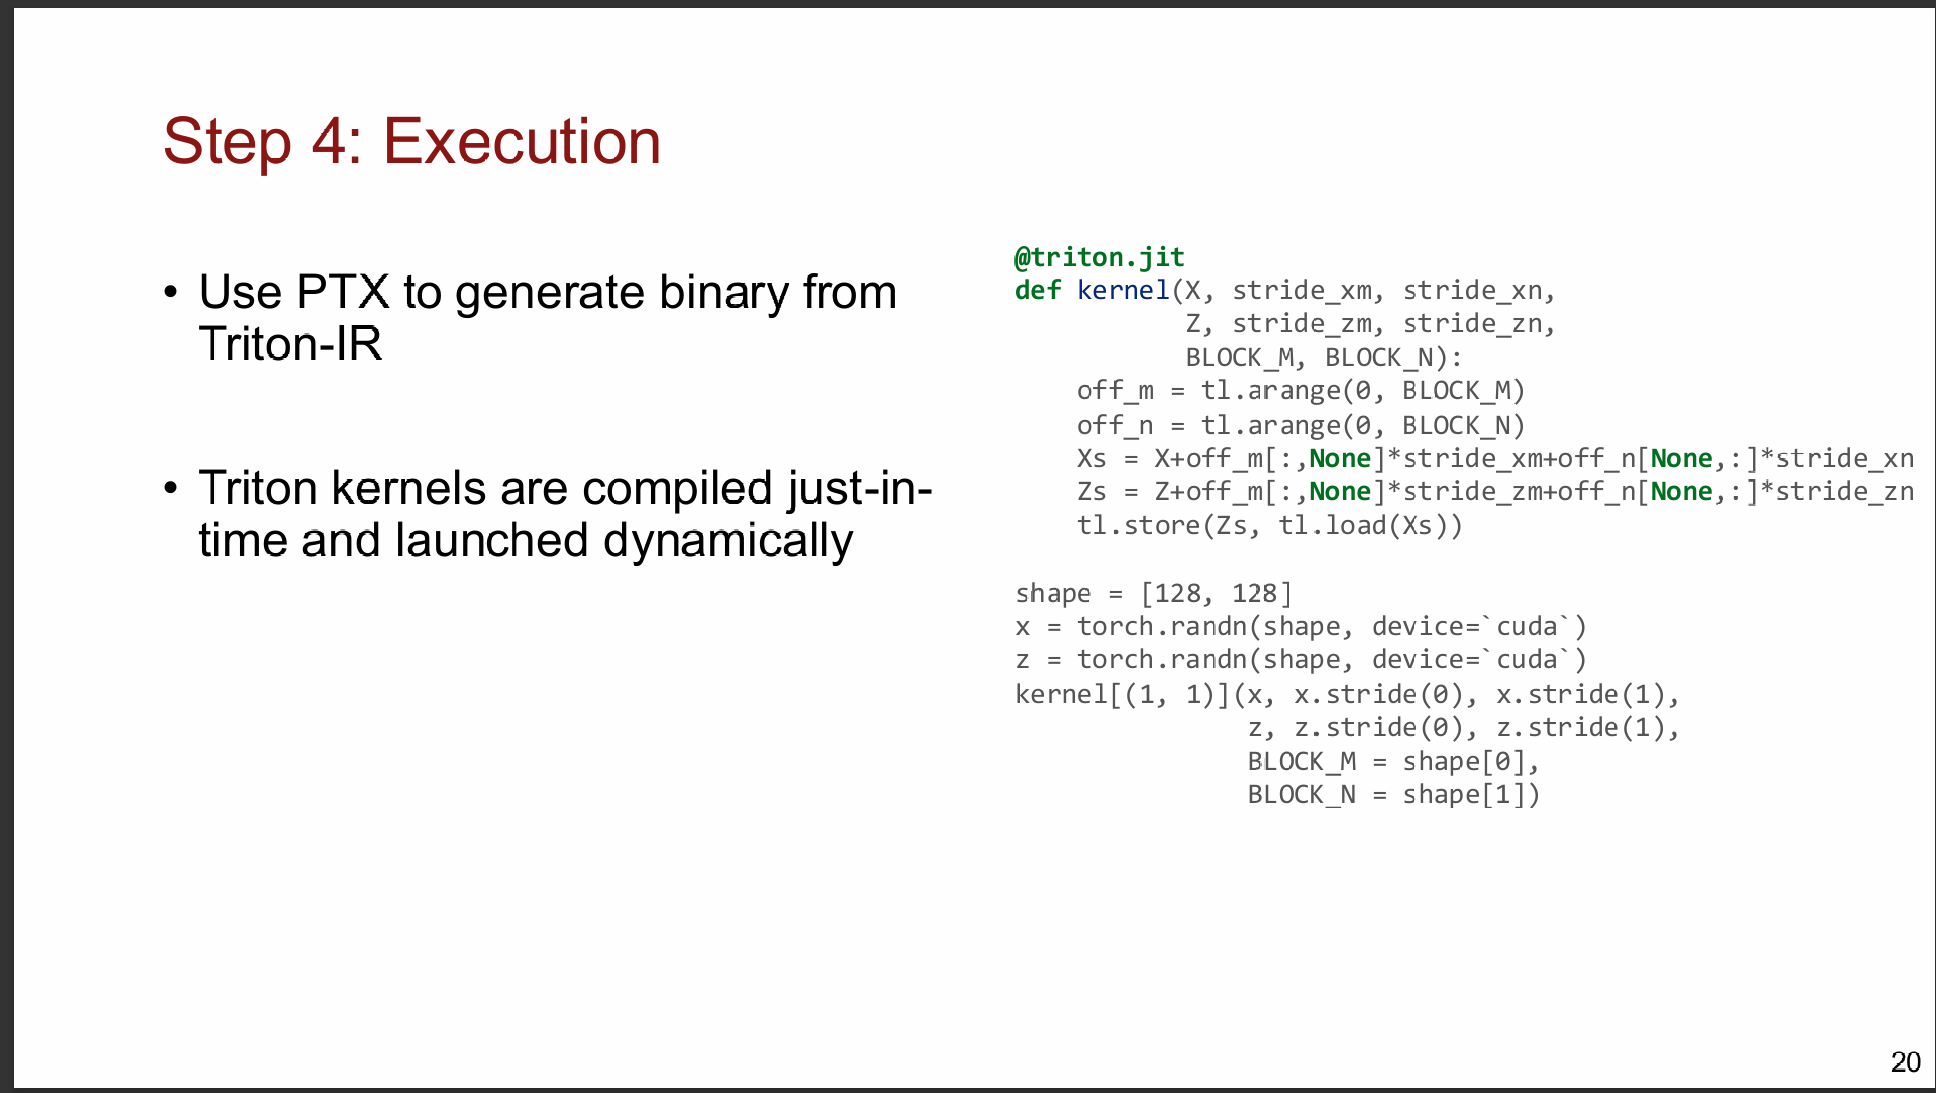
- 指令选择:为每种运算挑选最优的 PTX 指令。